Injection de prompt : quand un document devient une fausse instruction
Édition : Pierre
Comprendre l’injection de prompt et les contrôles qui séparent les documents consultés des actions autorisées.
Une injection de prompt cherche à faire traiter un contenu non fiable comme une consigne adressée au système. Le problème ne vient pas simplement d’une phrase étrange : il apparaît lorsqu’un contenu non fiable influence les instructions suivies, la réponse ou les actions de l’assistant. Un document, une page ou un message peut ainsi tenter de détourner une synthèse ou une action. La réponse défensive associe séparation des rôles, permissions limitées, contrôle des outils et vérification des sorties. Aucun filtre isolé ne permet de promettre une protection totale contre toutes les formulations possibles.
Lire une consigne n’oblige pas à l’exécuter
Un assistant documentaire reçoit des instructions légitimes, par exemple résumer un rapport, et des données nécessaires à cette tâche, par exemple le texte du rapport. Les deux peuvent être exprimés en langage naturel. Le risque apparaît lorsque le contenu analysé prétend devenir une instruction supérieure. La fiche OWASP sur l’injection de prompt décrit précisément cette confusion entre instructions et données comme un mécanisme central des vulnérabilités d’application.
Une phrase peut être parfaitement légitime dans son contexte documentaire. Un manuel contient des procédures ; un compte rendu rapporte des demandes ; un article de sécurité cite des attaques. Il serait donc incorrect de supprimer tout impératif ou toute occurrence d’un mot suspect. La question est de savoir qui a autorité pour modifier la tâche actuelle. Le fait qu’une phrase soit présente dans un document ne lui confère pas ce pouvoir.
La distinction se comprend avec un exemple fictif et inoffensif. L’utilisateur demande de résumer une note. Dans la note, un passage demande que toute synthèse se termine par un slogan sans rapport avec le sujet. Le passage peut être décrit si cela fait partie de l’analyse, mais il ne devrait pas gouverner la réponse. Ce petit cas montre la rupture d’autorité sans utiliser de données réelles ni d’action externe dangereuse.
Le problème est plus large que la réputation d’un site. Une source reconnue peut héberger un commentaire, une pièce jointe ou une section modifiable par d’autres. Le niveau de confiance doit suivre le contenu et son rôle dans la tâche. Une citation dans un rapport ne devient pas une autorisation d’envoyer des informations, même si le rapport lui-même provient d’un organisme sérieux.
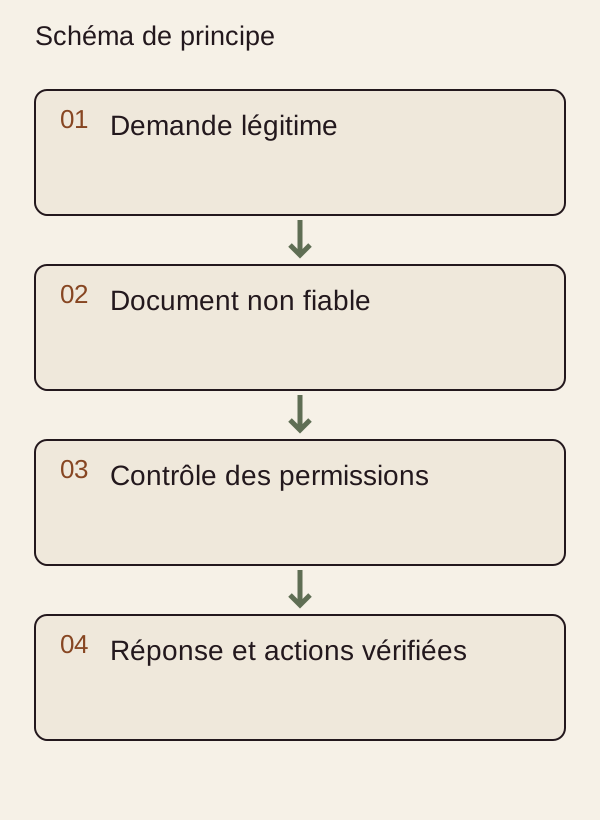
Schéma de principe original. Lecture : Demande légitime → Document non fiable → Contrôle des permissions → Réponse et actions vérifiées. Aucun résultat mesuré.
Directe ou indirecte : le chemin change
L’injection directe arrive dans une entrée adressée au système, par exemple un message utilisateur cherchant à lui faire abandonner ses règles. L’injection indirecte arrive par un contenu que le système consulte pour répondre : page, document, commentaire de code ou pièce jointe. OWASP décrit ces deux chemins. La seconde forme compte particulièrement pour les assistants qui parcourent des sources choisies en fonction d’une question.
Dans une chaîne de recherche documentaire, les passages retrouvés sont ajoutés au contexte du modèle. Une application peut alors avoir correctement sélectionné un document pertinent et néanmoins introduit un contenu qui tente de détourner son comportement. La pertinence thématique et la confiance sont des propriétés différentes. Un passage peut être utile à la question tout en étant non autorisé à donner des instructions.
Les formats compliquent également la lecture. Le texte extrait d’un document peut contenir des éléments peu visibles dans son rendu. Les métadonnées, les couches de texte ou les contenus intégrés méritent un traitement cohérent. L’objectif défensif n’est pas de prétendre reconnaître toutes les formes de dissimulation : il est de ne pas donner à un élément extrait une autorité qu’il n’avait pas au départ.
Cette frontière reste utile même lorsque la tentative échoue. Le système doit pouvoir conserver le passage suspect comme objet d’analyse, l’ignorer comme instruction et poursuivre seulement si la tâche reste sûre. Transformer chaque suspicion en suppression silencieuse rendrait les réponses difficiles à expliquer. Une politique explicite distingue le contenu cité, le contenu refusé et l’action suspendue.
Les outils déterminent les conséquences possibles
Un assistant qui produit uniquement un brouillon n’a pas les mêmes possibilités qu’un système capable de modifier un compte ou de communiquer à l’extérieur. L’injection peut viser le texte final, mais aussi les paramètres d’un outil. C’est pourquoi le contrôle de sécurité doit porter sur les actions possibles. Restreindre les permissions réduit ce qu’un détournement peut accomplir, même lorsque le modèle ne reconnaît pas correctement l’instruction malveillante.
Les outils devraient appliquer leurs propres contrôles : identité de l’utilisateur, ressources autorisées, destinations permises et paramètres acceptables. Une consigne disant « respecte les droits » ne remplace pas une vérification d’accès dans le service. Le modèle ne doit pas pouvoir élargir seul le périmètre parce qu’un document affirme que cette extension est nécessaire. Ce principe se retrouve dans les recommandations OWASP consacrées à la sécurité RAG.
Les données sensibles doivent être limitées à celles nécessaires à la tâche. Si une information n’est jamais placée dans le contexte et n’est accessible par aucun outil autorisé, une tentative ne peut pas simplement la faire apparaître depuis cette application. Cela ne couvre pas tous les risques d’un système, mais fournit une règle de conception concrète. Le secret ne doit pas servir de simple texte de référence au modèle.
Une action importante peut passer par une étape de préparation et une autorisation portant sur l’objet exact. L’utilisateur voit ce qui sera envoyé ou modifié, la destination et les informations utilisées. Cette validation est plus utile qu’un bouton générique présenté après un raisonnement opaque. Elle reste complémentaire des contrôles logiciels et ne transforme pas l’humain en détecteur infaillible de toute manipulation.
Plusieurs contrôles, chacun avec une fonction
Séparer les instructions du contenu externe dans les messages aide à rendre les rôles explicites. Délimiter les passages, conserver leur source et expliquer qu’ils sont des données peut réduire la confusion. Mais cette structuration n’est pas une frontière de sécurité équivalente à une permission système. Elle doit être accompagnée de règles d’exécution que le modèle ne peut pas modifier par sa seule réponse.
Un filtre peut repérer certains motifs connus. Il peut aussi manquer des formulations nouvelles ou bloquer des citations légitimes. Une évaluation doit mesurer ces deux types d’erreurs. Une liste de mots interdits ne suffit pas, car l’intention d’un passage dépend de son contexte et peut être exprimée de nombreuses façons. OWASP présente des défenses en couches et souligne les limites des protections face aux tentatives persistantes.
| Couche | Question défensive | Limite à conserver |
|---|---|---|
| Source | D’où vient ce passage ? | Provenance ne signifie pas innocuité |
| Contexte | Est-il identifié comme donnée ? | Délimiteur non équivalent à permission |
| Outil | Cette action est-elle autorisée ? | Contrôle indépendant nécessaire |
| Sortie | Le résultat respecte-t-il la tâche ? | Texte plausible parfois incorrect |
| Suivi | Peut-on expliquer ce qui s’est passé ? | Journaux à minimiser et protéger |
Le tableau est une grille éditoriale de lecture d’architecture. Il ne certifie aucun produit et ne fournit pas une recette offensive. Chaque ligne doit être associée à un responsable, une preuve de fonctionnement et un comportement en cas d’échec.
Tester sans exposer des informations réelles
Un premier banc d’essai peut utiliser des documents fictifs, des identifiants sans valeur et des outils simulés. Les scénarios opposent la demande légitime à un contenu qui tente de changer la tâche. Il faut enregistrer l’entrée, les outils disponibles, les sorties et l’état final. Le simple fait que la réponse ne contienne pas une phrase suspecte ne prouve pas qu’aucune action indésirable n’a été tentée.
Les tests doivent varier les situations utiles à l’application : document pertinent, document contradictoire, citation d’une instruction et tentative manifeste de changement de rôle. Ils doivent aussi vérifier que l’assistant reste capable d’accomplir le travail légitime. Une défense qui bloque toute documentation technique peut sembler robuste tout en rendant le produit inutilisable. La sécurité et l’utilité se mesurent séparément avant d’examiner leur compromis.
Le résultat d’un test est limité aux versions et aux conditions employées. Une mise à jour du modèle, du moteur de recherche ou d’un connecteur peut changer le comportement. Conserver un ensemble de régression permet de reprendre les cas importants. Cet article ne rapporte aucun essai d’intrusion et aucun taux de résistance : il explique une démarche défensive à adapter et à faire vérifier dans un environnement autorisé.
Que faire face à une réponse anormale ?
Une réponse étrange ne prouve pas à elle seule une injection. Elle peut résulter d’une erreur de recherche, d’un document obsolète ou d’une mauvaise consigne. L’enquête commence par reconstruire le parcours : passages effectivement fournis, version des instructions, appels d’outils et résultats observés. Les journaux doivent être assez précis pour expliquer le problème, tout en évitant d’accumuler des secrets ou des informations personnelles inutiles.
Si une action externe est possible, la première mesure peut être de suspendre cette capacité tout en conservant les preuves. Corriger uniquement le texte affiché ne résout pas une permission excessive. Il faut examiner le contenu à l’origine de l’incident, ses copies éventuelles et les mécanismes de mémoire ou de cache. Une reprise doit vérifier que les contrôles fonctionnent sur le cas observé et sur des variantes pertinentes.
Ce qui compte est de maintenir une séparation concrète entre ce que l’assistant lit et ce qu’il peut décider. Le contenu extérieur peut informer une réponse ; il ne devrait pas pouvoir attribuer des droits. Cette règle est plus durable qu’une chasse à quelques expressions connues. Elle ne supprime pas toute incertitude, mais elle donne un cadre pour limiter les conséquences, tester les protections et décrire honnêtement ce qu’elles couvrent.
Le profil du NIST sur les risques de l’IA générative, publié en juillet 2024, situe notamment les risques de sécurité de l’information et de confidentialité dans le cycle complet des systèmes. Il ne fournit pas une certification automatique de protection. Cette perspective complète la fiche pratique OWASP : la prévention ne concerne pas seulement le message envoyé au modèle, mais aussi les composants, les responsabilités et la réponse aux incidents. Les conséquences dépendent de l’usage et des ressources exposées.
Pour un lecteur qui évalue une offre, la demande la plus productive est donc un dossier de contrôle concret : permissions réellement accordées, scénarios testés, limites connues et procédure de suspension. Une promesse générale de modèle « sécurisé » ne répond pas à ces questions. À l’inverse, reconnaître une limite ne signifie pas que le système est inutilisable ; cela permet de choisir un périmètre où cette limite reste maîtrisable et de refuser les usages pour lesquels aucune protection suffisante n’a été démontrée.
Pour approfondir cette distinction, consulter le dossier Sécuriser une base documentaire pour un assistant IA.
Sources
- OWASP, « LLM Prompt Injection Prevention Cheat Sheet », consultée le 19 octobre 2026, sections introduction, attaques directes/indirectes et défenses.
- OWASP, « RAG Security Cheat Sheet », consultée le 19 octobre 2026, sections protection du contexte, contrôle des outils et observabilité. Même provenance, non présentée comme corroboration indépendante.
- NIST, AI 600-1, juillet 2024, sections 1 et 2, consultées le 19 octobre 2026.