RAG : comment une IA cherche dans vos documents avant de répondre
Édition : Pierre
Comprendre le RAG, du document à la réponse : découpage, recherche, sources et diagnostic des erreurs, avec un schéma et une grille pratique.
Un assistant RAG associe une recherche documentaire à un modèle de langue. Lorsqu’une question arrive, l’application retrouve des passages dans un corpus, les place dans le contexte du modèle et lui demande de formuler une réponse. Le modèle ne connaît donc pas nécessairement tous les documents : il travaille avec ceux que la recherche lui fournit à cet instant. Cette architecture facilite l’utilisation de connaissances propres à une organisation, mais elle n’assure ni que le bon passage sera retrouvé, ni que la réponse lui sera fidèle.
RAG signifie retrieval-augmented generation, ou génération augmentée par recherche. Le terme décrit une famille de systèmes, pas un produit précis. Pour comprendre une démonstration commerciale, il est plus utile de suivre le trajet d’un document que de compter les fonctionnalités annoncées. Une erreur peut naître avant même que le modèle ait commencé à écrire.
Deux formes de connaissance qui ne se confondent pas
Un modèle entraîné possède des paramètres : les valeurs ajustées pendant son apprentissage. Un système documentaire conserve, lui, des fichiers ou des enregistrements que l’application peut retrouver. Dans un RAG courant, ajouter une nouvelle notice à la base ne revient pas à réentraîner le modèle. La notice devient disponible pour la recherche, puis éventuellement pour la réponse à une question.
La publication de Lewis et ses coauteurs, présentée à NeurIPS en 2020, associait une mémoire paramétrique à un index dense de Wikipédia. Elle étudiait des formulations et des tâches précises. Ce travail constitue une référence historique de l’architecture ; ses résultats ne permettent pas de promettre la même performance à n’importe quel assistant d’entreprise. Présentation de la publication RAG.
Cette séparation apporte une question pratique : où faut-il intervenir lorsqu’une réponse devient obsolète ? Si la bonne règle figure dans une nouvelle version de la documentation, il faut vérifier sa présence dans le corpus et l’index. Modifier une consigne adressée au modèle ne corrige pas un index qui ne contient que l’ancienne version. Inversement, un index à jour ne suffit pas si l’application transmet finalement le mauvais passage.
Prenons un exemple fictif de catalogue industriel. Une entreprise possède une notice d’installation, une fiche de maintenance et un bulletin qui corrige une consigne. Un utilisateur demande quelle pièce remplacer. Il ne cherche pas un résumé des trois documents : il veut la consigne applicable à son équipement. Le système doit donc préserver les références, les versions et les conditions qui permettent de distinguer les cas.
Le document commence par être transformé
Avant la recherche, le contenu doit être rendu exploitable. Un fichier texte, un PDF composé d’images et un tableau n’arrivent pas dans les mêmes conditions. L’extraction peut perdre une colonne, mélanger l’ordre des lignes ou séparer une note du résultat qu’elle précise. Le nom du fichier encore visible ne prouve pas que son contenu a été correctement interprété.
Le découpage, souvent appelé chunking, transforme ensuite un grand document en passages plus petits. L’objectif est de pouvoir retrouver les parties utiles sans transmettre l’ensemble. Ce choix demande un arbitrage : un fragment très court peut manquer de contexte ; un fragment trop large peut transporter beaucoup d’informations qui ne répondent pas à la question. Il n’existe pas de taille idéale que l’on puisse choisir sans examiner le corpus et les usages.
Dans notre exemple, séparer « remplacer le filtre » de « uniquement sur la version révisée » créerait un passage dangereusement incomplet. Une préparation raisonnable conserve le titre de section, l’identifiant de l’équipement et l’exception. Elle permet aussi de remonter du fragment à la page d’origine. Ce n’est pas une préférence esthétique : ces informations déterminent le sens de la consigne.
La documentation Microsoft sur le RAG décrit notamment la préparation des contenus, leur découpage, la vectorisation et la sélection de passages. Elle présente plusieurs architectures propres à son service. Nous retenons ici ces étapes de préparation, sans reprendre comme résultats indépendants ses promesses de performance. Documentation Azure AI Search.
Retrouver un passage proche n’est pas prouver qu’il répond
La recherche peut s’appuyer sur les mots, sur des représentations numériques du texte ou sur une combinaison des deux. Une représentation vectorielle, ou embedding, permet de comparer des contenus dans un espace numérique. Elle peut rapprocher des formulations différentes. Cela ne transforme pas une proximité calculée en certificat de vérité, de fraîcheur ou d’applicabilité.
Dans un catalogue, un numéro de pièce exact peut être décisif. Une recherche qui privilégie seulement la proximité générale de sens pourrait trouver une notice ressemblante, mais concernant une autre référence. À l’inverse, une correspondance de mots peut manquer une réponse formulée avec un autre vocabulaire. Le choix du moteur doit être évalué sur les questions réellement posées, et non uniquement sur des exemples faciles préparés pour une démonstration.
Une étape de reclassement peut examiner les premiers résultats pour en améliorer l’ordre. Des filtres peuvent aussi limiter la recherche à une date, une langue ou une famille de produits. Chacune de ces opérations devrait être visible dans un diagnostic : quels candidats ont été trouvés, lesquels ont été retirés, quels passages ont finalement été transmis ? Sans cette trace, deux réponses différentes peuvent être difficiles à expliquer.
Le cas d’une question sans réponse est particulièrement instructif. Si aucune notice ne traite le problème, le moteur peut néanmoins produire une liste de passages voisins. Le fait d’obtenir des résultats ne signifie pas que l’information demandée existe. Un système utile distingue l’absence de document pertinent d’une réponse négative réellement écrite dans la documentation.
La génération ajoute une nouvelle étape d’interprétation
Les passages retenus sont insérés dans une requête, avec la question et les instructions de l’application. Le modèle produit alors une réponse. Il peut reformuler, rapprocher plusieurs extraits ou présenter une procédure. Cette souplesse rend l’interface agréable, mais elle introduit un écart possible entre le document et le texte final.
Une citation est donc un point de contrôle, pas une preuve automatique. Le lien peut conduire au bon document tout en accompagnant une phrase trop générale. Il faut vérifier le passage précis, ses conditions et ce qui a été ajouté dans la reformulation. Dans notre exemple, une réponse qui cite la notice mais omet la version du produit reste insuffisante pour choisir une pièce.
Pour une question qui exige plusieurs éléments, chaque étape du raisonnement doit être soutenue. Un document peut établir la compatibilité mécanique ; un autre peut préciser une procédure d’entretien. Le modèle ne devrait pas conclure à une autorisation d’utilisation qui ne figure dans aucun des deux. Cette règle de lecture est utile pour le lecteur comme pour l’équipe qui prépare les tests.
L’application doit également choisir ce qu’elle fait lorsqu’une preuve manque ou lorsque les documents se contredisent. Signaler la limite, montrer les passages incompatibles ou demander une précision sont des comportements à spécifier. Leur qualité se mesure sur des cas préparés à l’avance. Le présent dossier explique l’architecture ; il ne présente pas un assistant testé ni un taux de fiabilité mesuré.
Mettre à jour une base ne consiste pas seulement à ajouter des fichiers
Un corpus évolue. Des documents sont corrigés, remplacés ou supprimés. Si l’ancien passage reste présent dans l’index ou dans un cache, il peut continuer à influencer une réponse. L’actualisation doit donc suivre les objets dérivés du document, et pas seulement son emplacement dans le dossier d’origine.
Le guide OWASP consacré à la sécurité des chaînes RAG insiste sur la propagation des suppressions, la provenance et les contrôles d’accès avant que les passages atteignent le modèle. Les permissions d’un fichier ne sont pas automatiquement transmises à tous ses fragments. Nous signalons cette contrainte ici ; la conception détaillée des autorisations relève du dossier consacré à la base documentaire sécurisée. Guide RAG d’OWASP.
Le contenu documentaire doit aussi être traité comme une source d’information, non comme une instruction administrative. Une phrase présente dans un document ne doit pas pouvoir modifier à elle seule les permissions de l’application ou déclencher une action. Le fait qu’un passage ait été retrouvé dans une base interne ne lui confère pas une autorité supérieure aux règles du système.
Ces distinctions comptent lorsque l’assistant devient capable d’agir : créer un ticket, modifier une fiche ou envoyer un message. Chercher un texte, rédiger une réponse et exécuter une opération sont trois capacités différentes. Leur réunion dans une interface ne supprime pas la nécessité de vérifier séparément les preuves, les autorisations et le résultat de l’action.
Une grille pour localiser l’erreur avant de changer de modèle
La grille suivante est une proposition de diagnostic construite pour ce dossier. Elle ne note aucun fournisseur. Son intérêt est d’obliger l’équipe à identifier l’étape en défaut avant de modifier tous les composants à la fois.
| Symptôme observé | Première vérification | Preuve à conserver |
|---|---|---|
| Le document attendu n’apparaît jamais | Présence dans le corpus et réussite de l’extraction | Version du fichier et texte extrait |
| Le bon document apparaît, mais pas l’exception | Découpage et contexte des fragments | Passage stocké, titre et page d’origine |
| Une autre référence produit est choisie | Recherche exacte, filtres et classement | Question et liste des candidats |
| Les extraits sont corrects, la réponse ne l’est pas | Reformulation et appui de chaque proposition | Requête finale, réponse et passages cités |
| Une règle supprimée réapparaît | Index et caches encore utilisés | Identifiants des objets dérivés et dates |
| Une information non autorisée est montrée | Filtrage avant transmission au modèle | Périmètre de test et journal d’accès |
Une première recette peut utiliser quelques documents publics ou fictifs dont les réponses sont connues. Il est utile de prévoir un cas simple, une exception, deux versions successives, un identifiant rare, un document contradictoire et une question sans réponse. Les quantités ne constituent pas un standard : c’est la diversité des erreurs possibles qui donne sa valeur au jeu de tests.
Pour chaque question, écrire d’abord le passage attendu et la conclusion autorisée. Examiner ensuite la recherche séparément de la réponse rédigée. Si le passage manque, changer seulement la formulation finale a peu de chances de résoudre le problème de fond. Si le passage est présent, conserver cette réussite et concentrer l’analyse sur l’utilisation qui en est faite.
La comparaison de deux configurations doit enfin conserver les mêmes documents et les mêmes questions. Sinon, une amélioration apparente peut venir d’un corpus plus facile ou d’une correction documentaire. Le dossier de test doit permettre de distinguer ce qui a changé dans les données, le moteur de recherche, les consignes et le modèle.
Ce que cela change pour une entreprise
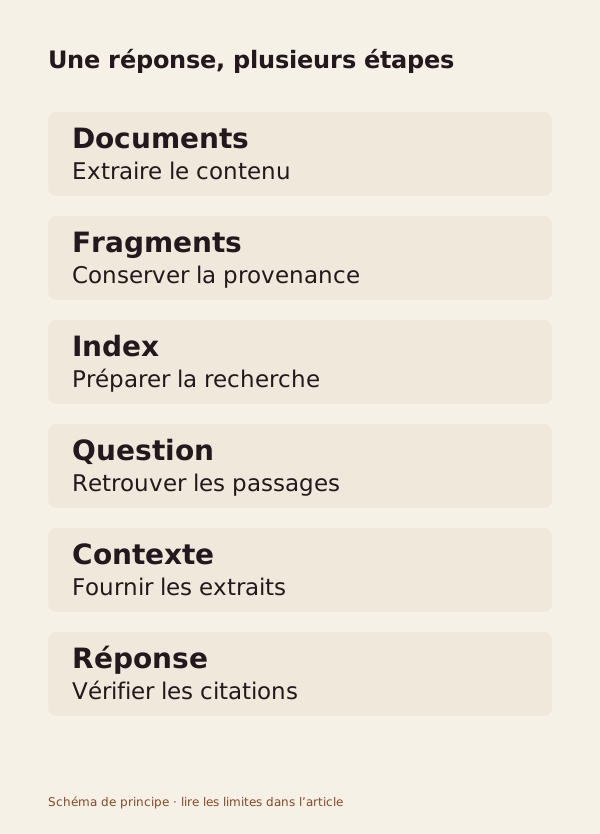
Avant de choisir un assistant, demander à voir une question traverser toute la chaîne : fichier d’origine, extraction, fragments, résultats de recherche, contexte transmis et réponse. Cette démonstration révèle les dépendances que masque une conversation fluide. Elle permet aussi de répartir les responsabilités entre l’équipe documentaire, l’intégrateur et les utilisateurs qui connaissent les cas métier.
La décision dépend du besoin. Retrouver une référence exacte, résumer un dossier et préparer une réponse à un client ne demandent pas les mêmes contrôles. Une base propre peut être un meilleur investissement initial qu’un changement de modèle, mais cette priorité doit être établie à partir des erreurs observées. Elle ne se déduit pas du seul mot RAG.
Ce qui reste à démontrer, pour tout projet concret, est la capacité à retrouver les bons éléments, à respecter leurs limites et à maintenir cette qualité lorsque les documents changent. Le RAG rend la source consultable dans le fonctionnement du système. Il ne dispense jamais de vérifier que la conclusion suit réellement cette source.
Sources
- Lewis et al., publication RAG, NeurIPS 2020 ; résumé et notice de publication consultés le 19 octobre 2026. Aucun résultat chiffré du papier n’est extrapolé.
- Microsoft Learn, Retrieval-augmented generation in Azure AI Search, documentation consultée le 19 octobre 2026 ; architecture fournisseur, pas évaluation indépendante.
- OWASP, RAG Security Cheat Sheet, consultée le 19 octobre 2026 ; recommandations techniques, pas certification de notre système.
- Exemple de catalogue et grille de diagnostic : constructions pédagogiques originales, sans données d’entreprise ni essai de fournisseur.