Données synthétiques : utiles pour entraîner, insuffisantes pour prouver ?
Édition : Célia
Définir le rôle des données synthétiques et préserver une validation indépendante pour juger leur apport réel.
Les données synthétiques sont produites artificiellement, par exemple par une simulation, des règles ou un modèle génératif. Elles peuvent aider à fabriquer des variantes, explorer des cas ou préparer un apprentissage. Leur utilité dépend toutefois de ce qu’elles représentent et de la manière dont elles sont vérifiées. Un jeu généré ne devient pas automatiquement anonyme, diversifié ou fidèle au terrain. Surtout, réussir sur des données produites par le même mécanisme que l’entraînement ne suffit pas à démontrer une performance réelle. Il faut conserver une validation dont la provenance permet de tester autre chose que les habitudes du générateur.
Un mot qui recouvre des fabrications différentes
Un jeu synthétique peut être obtenu par des règles simples, une simulation physique ou un modèle appris. Ces méthodes n’impliquent pas les mêmes hypothèses. Une règle peut garantir la cohérence d’un format sans reproduire la diversité d’un comportement humain. Une simulation peut représenter certains mécanismes tout en simplifiant d’autres. Un modèle génératif peut produire des exemples plausibles qui héritent de ses données et de ses limites.
Il faut donc décrire le procédé avant de juger le résultat. Qui ou quoi produit les exemples ? À partir de quelles informations ? Avec quelles contraintes et quels filtres ? Le mot synthétique renseigne sur l’origine artificielle, pas sur la qualité. Une donnée peut être entièrement générée et pertinente pour une tâche limitée ; une autre peut sembler réaliste tout en omettant précisément les situations qui comptent.
Prenons un exemple fictif de formulaires de livraison. Des règles peuvent varier les champs, les formats de date et les informations manquantes pour vérifier qu’un programme les traite correctement. Ce jeu aide à tester une interface. Il ne démontre pas que les textes libres ressemblent aux messages réels des clients. Les deux objectifs demandent des preuves différentes et doivent rester séparés dans le dossier.
La même prudence s’applique à l’apprentissage. Générer davantage d’exemples ne garantit pas d’ajouter davantage d’information utile. Si les exemples répètent la même structure, le volume augmente sans que toutes les situations soient mieux couvertes. Il faut regarder les variations pertinentes pour la tâche, pas seulement le nombre de lignes produites.
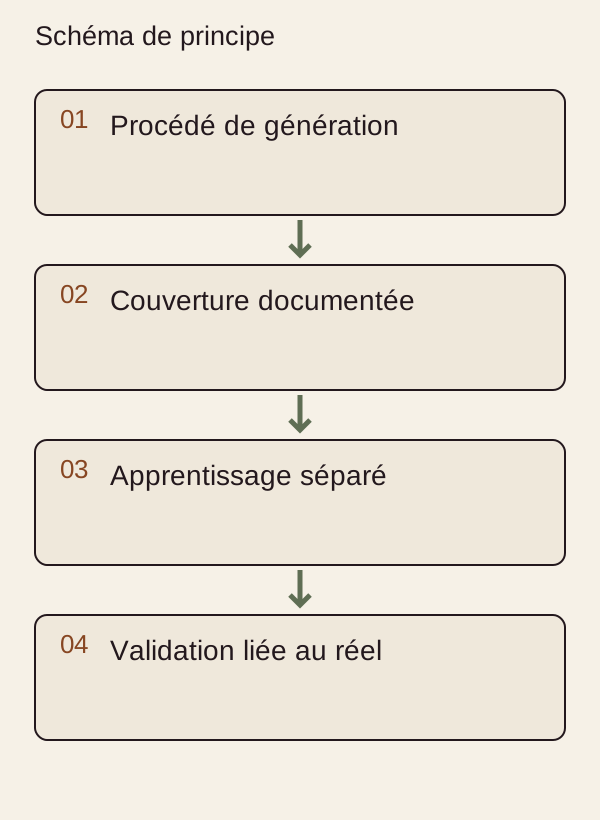
Schéma de principe original. Lecture : Procédé de génération → Couverture documentée → Apprentissage séparé → Validation liée au réel. Aucun résultat mesuré.
La diversité doit être définie avant d’être revendiquée
Une bibliothèque de questions peut varier les mots tout en conservant le même raisonnement. Une collection d’images peut varier les couleurs tout en montrant toujours le même angle. La diversité utile dépend de ce que le système devra distinguer. Pour une extraction documentaire, les mises en page, les unités et les informations absentes peuvent compter davantage que le style des phrases.
Une carte de couverture aide à rendre ce choix explicite. Elle énumère les dimensions importantes : type de demande, ambiguïté, langue, format ou exception métier. Pour chacune, elle indique les cas générés, les cas observés et ceux qui manquent. Cette carte est une construction de l’équipe ; elle ne doit pas être présentée comme une distribution représentative du monde réel sans enquête correspondante.
Le générateur peut aussi favoriser les réponses habituelles ou les formes les plus faciles à produire. Les cas rares risquent alors d’être moins présents. Ajouter une consigne demandant « beaucoup de diversité » ne prouve pas que ces cas ont été couverts. Il faut les définir, les rechercher dans le jeu et vérifier leur exactitude. Une diversité annoncée devient ainsi une question contrôlable.
La publication de Shumaylov et ses coauteurs dans Nature étudie un phénomène de dégradation lorsque des générations de modèles apprennent récursivement sur des données produites par leurs prédécesseurs. Elle montre notamment, dans les configurations examinées, une perte d’information sur certaines parties de la distribution. Ce résultat ne signifie pas que toute donnée synthétique est inutilisable : il souligne l’importance du procédé, du mélange de données et de l’accès à une référence réelle.
Ne pas transformer le générateur en juge unique
Si le même modèle produit les exemples, les réponses attendues et la note finale, l’évaluation mesure en partie sa propre cohérence. Cela peut être utile pour un contrôle de format ou pour repérer des anomalies simples. Ce n’est pas une validation indépendante de la vérité. Une erreur stable peut traverser toutes les étapes sans être contestée.
Pour un calcul, une vérification déterministe peut servir de référence. Pour une règle métier, il faut la règle approuvée. Pour un fait documentaire, il faut un passage source. Pour une tâche liée à des comportements réels, il faut des observations pertinentes et un protocole d’annotation. Le choix de la référence dépend de la question, mais il doit être extérieur au simple fait que le générateur approuve sa sortie.
La séparation entre entraînement et test doit tenir compte de la fabrication. Deux lots produits avec des consignes très proches peuvent partager des structures et des réponses implicites. Les séparer en fichiers ne suffit pas toujours à créer une véritable nouveauté. Il faut examiner les familles d’exemples et réserver des situations dont l’origine et la sélection diffèrent suffisamment pour évaluer la généralisation recherchée.
La documentation Transformers sur l’apprentissage permet d’organiser des ensembles d’entraînement et d’évaluation. Elle ne décide pas à la place de l’équipe ce qui constitue un test pertinent. La qualité d’une séparation ne se réduit pas à l’appel d’une fonction logicielle : elle dépend du lien entre les données, leur provenance et l’objectif réel.
Synthétique ne veut pas dire anonyme
Un exemple généré peut être construit à partir de données personnelles ou reproduire des informations issues de ses entrées. Remplacer un nom ne suffit pas à démontrer qu’une personne ne peut plus être identifiée. Il faut examiner les détails conservés, les combinaisons possibles et le contexte d’utilisation. Par précaution méthodologique, nous recommandons donc de demander une analyse de confidentialité adaptée ; l’étiquette synthétique ne fournit pas à elle seule cette preuve. Ce point est une règle de vérification proposée ici, pas un résultat mesuré dans l’étude sur l’apprentissage récursif.
La CNIL décrit les approches d’IA générative et leurs risques, dont les questions de données et de choix de système. Cette page générale ne constitue pas une étude spécifique de la réidentification dans des jeux synthétiques. Le besoin et les risques doivent guider la préparation. Dans un projet concret, les droits d’usage et la confidentialité concernent les données servant à générer, les sorties retenues et le service éventuellement utilisé pour les produire.
Il faut également conserver la possibilité d’expliquer les transformations. Quelles informations ont été supprimées ? Quelles contraintes ont été appliquées ? Qui a vérifié les exemples ? Une procédure documentée permet de discuter la réduction de risque, sans promettre une anonymisation automatique. Les jeux sensibles doivent rester hors des services ou périmètres non autorisés.
Une carte provenance, usage, validation
La contribution pratique suivante propose de relier l’origine artificielle à la preuve attendue. Elle ne constitue ni un classement des méthodes ni une mesure de performance. Chaque ligne décrit une question à résoudre avant de réutiliser le jeu.
| Usage | Apport possible | Vérification nécessaire |
|---|---|---|
| Tester un format | Variantes contrôlées de champs | Règles de validation explicites |
| Couvrir une exception | Cas rares préparés | Validité de la situation |
| Entraîner un style | Exemples réguliers | Qualité sur textes nouveaux |
| Apprendre une décision | Réponses proposées | Référence indépendante |
| Réduire l’exposition | Transformation d’entrées | Analyse de réidentification |
| Évaluer le terrain | Scénarios simulés | Confrontation à des cas réels |
La carte doit être complétée par un registre de production : méthode, version du générateur, consignes, filtres, dates et motifs d’exclusion. Il n’est pas nécessaire de conserver des données sensibles inutiles pour obtenir cette traçabilité. L’objectif est de pouvoir reconstruire une décision et retrouver les familles d’exemples qui expliquent une erreur.
Ce que l’expérience doit réellement comparer
Pour mesurer l’apport d’un jeu synthétique, il faut une référence sans cet ajout et des conditions comparables. Le modèle de base, les réglages importants et le test doivent être documentés. Si plusieurs éléments changent simultanément, une amélioration ne peut pas être attribuée proprement aux données générées. La comparaison doit aussi mesurer les régressions, pas seulement le cas favorable.
Le résultat doit être présenté par tâche et par population pertinente. Une hausse sur des exemples similaires au générateur peut coexister avec une baisse sur des formulations réelles. Une moyenne peut masquer cette différence. L’expérience doit donc expliquer quelles données ont servi à apprendre et quelles données ont servi à juger, avec leurs limites de représentativité.
Cet article ne rapporte pas un entraînement ni un taux de gain. Il explique les conditions d’une expérience interprétable et s’appuie sur des documents consultés. Les résultats de la publication sur l’apprentissage récursif ne sont pas transformés en pourcentage universel de dégradation. Ils servent à identifier une question de méthode : comment éviter de remplacer progressivement la référence que l’on cherche à modéliser par ses propres approximations ?
Garder une place pour ce qui résiste à la génération
Les données réelles contiennent des ambiguïtés, des contradictions et des informations manquantes. Les nettoyer ou les simplifier peut être nécessaire, mais il faut comprendre ce que cette opération retire. Un outil destiné au terrain rencontrera souvent ces difficultés. Un jeu synthétique parfaitement ordonné ne devrait pas conduire à oublier le travail nécessaire pour les traiter.
Ce qui compte est de donner aux données générées un rôle explicite. Elles peuvent compléter, explorer ou préparer. Elles peuvent aussi constituer l’objet d’une expérience utile. Mais une preuve d’efficacité doit rester liée à une tâche et à une validation pertinente. Le bon dossier indique à la fois ce que le synthétique apporte et ce qu’il ne représente pas encore ; cette limite est une information de conception, pas un détail à masquer.
Une revue peut commencer par choisir quelques exemples au hasard puis rechercher ce qui les relie au réel. Pour chacun, l’équipe note la règle de fabrication, la réponse attendue et la preuve permettant de l’approuver. Si cette preuve manque, l’exemple peut rester utile à une exploration, mais ne devrait pas devenir silencieusement une vérité d’entraînement. Cette distinction permet de garder des données intéressantes sans leur attribuer une autorité qu’elles n’ont pas.
Il faut enfin conserver les exclusions. Un jeu de données propre résulte souvent de choix : réponses trop ambiguës, sujets difficiles, formats inhabituels. Documenter ces retraits aide à comprendre les limites du modèle obtenu. Une catégorie supprimée du jeu ne disparaît pas des demandes futures. Le système devra soit la traiter avec une preuve suffisante, soit reconnaître qu’elle se trouve hors de son périmètre validé.
Pour approfondir cette distinction, consulter le dossier Distillation : comment un petit modèle apprend d’un plus grand.
Sources
- Shumaylov et coauteurs, « AI models collapse when trained on recursively generated data », Nature, 24 juillet 2024, introduction et définition du phénomène consultées le 19 octobre 2026.
- Hugging Face, documentation Transformers « Fine-tuning », consultée le 19 octobre 2026.
- CNIL, questions-réponses sur les systèmes d’IA générative, 18 juillet 2024, consultées le 19 octobre 2026.