Quantification des modèles : moins de mémoire, quels compromis ?
Édition : Pierre
Lire une quantification en quatre ou huit bits : poids, mémoire totale, matériel et qualité doivent être vérifiés séparément.
Quantifier un modèle consiste à représenter certains nombres avec moins de précision. Cela peut réduire la place occupée par ses paramètres et faciliter son exécution sur un matériel limité. Mais « modèle en quatre bits » ne signifie ni mémoire totale divisée par quatre, ni vitesse multipliée par quatre, ni qualité inchangée. Il faut savoir quels éléments sont quantifiés, comment les calculs sont réalisés et sur quelles tâches la version obtenue a été évaluée. Le nombre de bits constitue un indice technique utile ; il ne remplace pas un dossier de compatibilité et une mesure du système complet.
Des nombres à ranger dans moins de cases
Les paramètres d’un réseau neuronal sont des valeurs numériques. Leur représentation informatique possède une précision finie. La quantification choisit une représentation plus compacte, avec moins de valeurs disponibles ou une autre répartition de ces valeurs. Deux nombres proches peuvent alors être représentés de la même manière. Cette perte de détail est précisément le compromis : conserver suffisamment d’information pour réaliser la tâche tout en réduisant certaines contraintes de stockage ou de calcul.
L’analogie d’une graduation de règle est utile. Une règle moins finement graduée permet encore de mesurer une table, mais elle arrondit davantage certaines distances. Dans un réseau, les valeurs interviennent dans des calculs successifs ; l’effet final ne se déduit donc pas d’une simple erreur d’arrondi isolée. Selon les couches et les entrées, une modification peut avoir peu d’effet ou changer une décision. L’analogie explique la précision, pas le comportement complet du modèle.
La documentation de Hugging Face distingue de nombreuses méthodes et leurs compatibilités. Certaines nécessitent une calibration, d’autres permettent une conversion lors du chargement. Cette diversité interdit de traiter toutes les variantes portant la même étiquette numérique comme des objets équivalents. Le type de nombres, la méthode et les opérations effectivement accélérées participent tous au résultat.
Un fichier quantifié peut également contenir plusieurs précisions. Certaines parties restent dans un format plus large, tandis que d’autres sont compressées. Des informations auxiliaires servent à interpréter les valeurs compactes. Le nom commercial ou le suffixe du fichier ne suffit pas à décrire ce contenu. La fiche du modèle et la documentation de son moteur d’exécution doivent préciser ce qui a été transformé et ce qui est resté inchangé.
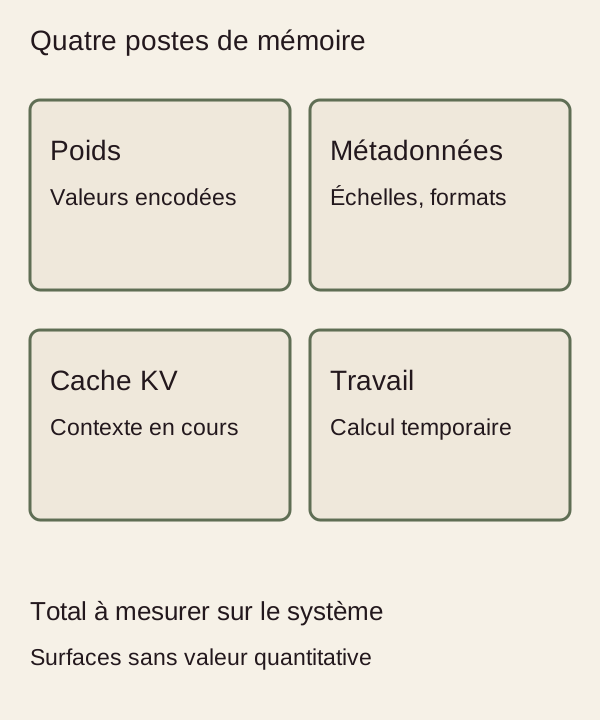
Postes de mémoire distincts ; surfaces sans proportions mesurées.
Le calcul que l’on peut faire, et celui qu’il faut mesurer
Une estimation de stockage des seuls poids commence par une formule simple : nombre de paramètres multiplié par nombre de bits, puis division par huit pour obtenir des octets. Prenons un exemple purement illustratif d’un milliard de paramètres, tous stockés uniformément. À seize bits, la charge brute représente deux milliards d’octets ; à quatre bits, elle représente cinq cents millions d’octets. Le rapport théorique des deux charges brutes est quatre.
Cette arithmétique n’est pas une mesure de mémoire d’un logiciel. Elle ignore notamment les métadonnées de quantification, les parties non quantifiées, les buffers temporaires et les données de travail. Elle suppose aussi un stockage effectivement compact, sans surcoût d’alignement. Il faut donc présenter son résultat comme un point de départ explicite. Déduire directement une capacité matérielle à acheter à partir de ce calcul exposerait à une mauvaise surprise.
Lors de la génération, le système conserve aussi des informations relatives au contexte traité. Le cache utilisé pour éviter de recalculer certaines opérations peut devenir important avec de longs échanges ou plusieurs requêtes simultanées. La documentation Hugging Face intègre ainsi le cache dans son outil d’estimation de compatibilité. Le fait qu’un modèle se charge ne prouve pas qu’il peut traiter le contexte et le nombre d’utilisateurs prévus.
Il faut distinguer un stockage sur disque, la mémoire au repos après chargement et le pic de mémoire pendant une requête. Ces trois nombres répondent à des questions différentes. Une archive légère facilite le transfert ; une consommation limitée après chargement facilite l’installation ; un pic maîtrisé conditionne l’exécution réelle. Le dossier de mesure doit indiquer l’état exact du système auquel chaque valeur se rapporte.
La méthode doit rencontrer le bon matériel
Une opération représentée avec peu de bits n’est pas nécessairement exécutée plus vite. Le matériel et le moteur doivent savoir exploiter le format choisi. Des conversions peuvent être nécessaires. Certaines opérations restent réalisées dans une précision supérieure. Le temps gagné sur une partie du calcul peut être réduit par le coût de ces transformations ou par un autre goulot d’étranglement. Un résultat observé sur une carte ne se transpose donc pas automatiquement à un ordinateur différent.
La compatibilité se vérifie à plusieurs niveaux : architecture du modèle, bibliothèque, format du fichier, processeur ou accélérateur, pilotes et version du moteur. Une documentation indiquant qu’une méthode fonctionne sur un GPU ne décrit pas nécessairement toutes les architectures de GPU. Pour choisir, conserver la configuration exacte vaut mieux qu’une mention générale « compatible ». Un exemple fonctionnel dans un environnement voisin reste une piste à reproduire.
Les logiciels évoluent aussi. La page officielle PyTorch consacrée à la quantification, consultée le 19 octobre 2026, oriente le développement vers torchao et décrit des migrations d’API. Cela illustre pourquoi une recette ancienne peut ne plus correspondre à la chaîne actuelle. Cet article n’impose aucune version de bibliothèque et ne prétend pas avoir exécuté les exemples documentaires : l’installation doit être préparée sur un environnement identifié.
| Vérification | Document à demander | Résultat qui ne suffit pas |
|---|---|---|
| Format | Description du checkpoint et de la méthode | Mention « quatre bits » seule |
| Matériel | Matrice de compatibilité datée | Même marque de GPU |
| Mémoire | Pic avec contexte et concurrence visés | Chargement réussi |
| Vitesse | Mesure sur la tâche et le moteur retenus | Taille du fichier divisée |
| Qualité | Erreurs sur cas représentatifs | Réponse fluide à une question |
Cette grille est une proposition de lecture du dossier technique. Elle ne classe pas les méthodes : le bon choix dépend précisément des conditions que ses lignes rendent visibles.
La calibration apprend où placer les approximations
Certaines techniques utilisent un ensemble de données de calibration pour observer le fonctionnement du modèle et déterminer comment représenter les valeurs. Ces données ne sont donc pas un accessoire interchangeable. Elles doivent ressembler suffisamment aux usages pertinents pour que les choix effectués ne soient pas uniquement adaptés à une situation artificielle. Une calibration sur du texte court ne constitue pas, par elle-même, une validation de documents longs ou de tableaux.
D’autres approches effectuent une quantification sans ce travail préalable, ou apprennent en tenant compte des approximations pendant l’entraînement. Il faut éviter de déduire une hiérarchie universelle de ces différences. Elles décrivent des coûts de préparation, des possibilités de réglage et des contraintes distinctes. Une méthode plus complexe peut être injustifiée pour un besoin simple ; une méthode facile à appliquer peut manquer les exigences d’un autre usage.
La provenance du checkpoint reste nécessaire même lorsque la conversion a été faite par une communauté. Quel modèle de départ a servi ? Avec quelle révision ? Quel programme a produit le fichier ? Le fichier est-il accompagné d’une documentation et d’une licence cohérentes ? Ces questions ne démontrent pas une malveillance lorsque l’information manque. Elles déterminent ce qui peut être expliqué et reproduit avant une intégration.
Comparer la qualité sans déplacer le problème
Une comparaison utile conserve la même tâche et la même grille de correction. On part du modèle de référence et de sa version quantifiée, avec les paramètres d’inférence documentés. Le contexte fourni, les consignes et les règles de réussite restent comparables. Si le moteur, la température ou le modèle de base changent simultanément, une différence ne peut plus être attribuée clairement à la quantification.
Les tâches doivent refléter les conséquences réelles des erreurs. Pour une extraction de données, contrôler séparément les champs manquants, les valeurs inventées et les associations incorrectes. Pour un résumé, vérifier les omissions importantes et les contradictions. Pour une classification, examiner les catégories difficiles. Une réponse élégante ne suffit pas à conclure que la compression a conservé la capacité recherchée, et un score moyen peut masquer une dégradation sur un cas rare mais critique.
L’évaluation devrait également inclure les cas limites : données incomplètes, documents longs, formulations inhabituelles et situations où il faut répondre que l’information manque. Les seuils d’acceptation dépendent de l’usage. Il n’existe pas de pourcentage de perte universellement acceptable. Le responsable du processus doit pouvoir expliquer pourquoi une erreur donnée est tolérable ou nécessite une vérification humaine.
Le temps de réponse mérite le même soin. Il faut distinguer le démarrage, le traitement du contexte et la génération de la réponse, puis observer leur combinaison dans le parcours réellement utilisé. La concurrence change aussi les conditions. Aucun chiffre de vitesse n’est donné ici, car aucun benchmark matériel n’a été exécuté pour cet article. La méthode de comparaison est proposée ; ses résultats restent à produire pour chaque configuration.
Quand la mémoire économisée ne suffit pas
Un modèle plus compact peut résoudre une contrainte d’hébergement sans résoudre la tâche métier. S’il ne trouve pas le document pertinent ou si les droits d’accès sont mal gérés, sa représentation numérique n’est pas la cause centrale. De même, la réduction de mémoire ne corrige pas une consigne ambiguë ni une règle de décision contradictoire. Il faut relier le changement technique à un problème observé, sous peine d’optimiser un indicateur secondaire.
La mémoire libérée peut être réutilisée pour davantage de contexte ou de requêtes, mais cette possibilité doit être testée. Elle ne justifie pas de remplir automatiquement toute la capacité disponible. Une marge aide à absorber les variations d’entrée et les besoins temporaires du moteur. Le dimensionnement final doit décrire le scénario normal, les pointes attendues et le comportement en cas de dépassement : refus contrôlé, réduction de charge ou traitement différé.
Ce qui compte est la combinaison obtenue : format documenté, exécution compatible, mémoire mesurée et qualité acceptable sur le besoin défini. La quantification est alors une technique d’ingénierie dont on peut expliquer les bénéfices et les limites. Sans ces informations, quatre bits restent quatre bits : une indication sur la représentation de certains nombres, pas une promesse complète sur le service rendu.
Pour approfondir cette distinction, consulter le dossier Distillation : comment un petit modèle apprend d’un plus grand.
Un compte rendu de mesure devrait permettre de refaire exactement la comparaison. Nous proposons d’y noter le fichier de poids, le format chargé, la longueur du contexte, le nombre de requêtes simultanées et la version du moteur. Il faut aussi préciser quand la mémoire a été observée : au chargement, pendant la génération ou au maximum atteint. Deux nombres relevés à des moments différents ne répondent pas à la même question. Cette fiche ne garantit pas une expérience parfaite ; elle rend au moins les désaccords discutables sur des conditions visibles.
Sources
- Hugging Face, « Quantization overview », documentation consultée le 19 octobre 2026, capture conservée.
- PyTorch, « Quantization », documentation officielle consultée le 19 octobre 2026 ; date de modification affichée : 11 mai 2026.
- Calcul illustratif du stockage brut : entrées et formule explicitées dans le corps, sans mesure matérielle.