Fine-tuning : ce que réentraîner un modèle change vraiment
Édition : Sophie
Comprendre ce que le fine-tuning modifie, préparer les exemples et comparer une adaptation à une consigne sur des cas nouveaux.
Le fine-tuning adapte un modèle déjà entraîné en modifiant une partie ou l’ensemble de ses paramètres à partir de nouveaux exemples. Il peut servir à rendre une tâche plus régulière, à apprendre un format ou à spécialiser un comportement. Il ne transforme pas automatiquement le modèle en base documentaire fiable. Avant de lancer un entraînement, la question utile est donc précise : quelle erreur persistante les exemples doivent-ils corriger, et comment vérifier que cette correction fonctionne sur des cas jamais vus ? La réponse détermine les données nécessaires, la méthode d’adaptation et les tests à conserver.
Une modification durable, différente d’une consigne
Un modèle de langue produit ses réponses à partir de paramètres numériques, souvent appelés poids. Le préentraînement ajuste ces paramètres sur un vaste ensemble de données. Une adaptation ultérieure repart de cet état et poursuit un apprentissage plus ciblé. La documentation de Transformers présente ce transfert comme une manière de réutiliser les capacités d’un modèle préentraîné pour une tâche donnée. Cette définition ne dit rien, à elle seule, de la qualité obtenue dans une entreprise particulière.
Une consigne agit autrement. Elle décrit ce qu’il faut faire dans le contexte de la requête : adopter un format, prendre en compte une exception, utiliser une terminologie. Elle ne modifie pas durablement les paramètres du modèle pendant cette utilisation. Ajouter quelques exemples dans la consigne peut déjà résoudre un problème de présentation. Cela fournit une référence simple à laquelle comparer une adaptation : si le résultat devient satisfaisant avec une instruction mieux formulée, l’entraînement n’est peut-être pas le chantier prioritaire.
La recherche documentaire apporte encore autre chose. Elle fournit au modèle des passages sélectionnés au moment de répondre. On l’appelle souvent RAG, pour génération augmentée par récupération. Une politique commerciale changeante, un catalogue ou une procédure datée se prêtent à cette approche lorsque le besoin consiste à retrouver la version pertinente. Apprendre des habitudes de réponse et retrouver une information sont deux fonctions différentes, qui peuvent être combinées. Les opposer systématiquement empêcherait de diagnostiquer la véritable origine de l’erreur.
Prenons un exemple fictif : un service classe des messages entrants. Si les catégories sont ambiguës, aucun entraînement ne dispense de les définir. Si le modèle connaît les catégories mais ne respecte pas le format demandé, une consigne et un contrôle de sortie constituent une première expérience. Si les frontières restent mal appliquées sur des messages variés, un ensemble d’exemples annotés peut devenir pertinent. Si la réponse dépend du statut actualisé d’une commande, il faut surtout accéder à la donnée correcte.
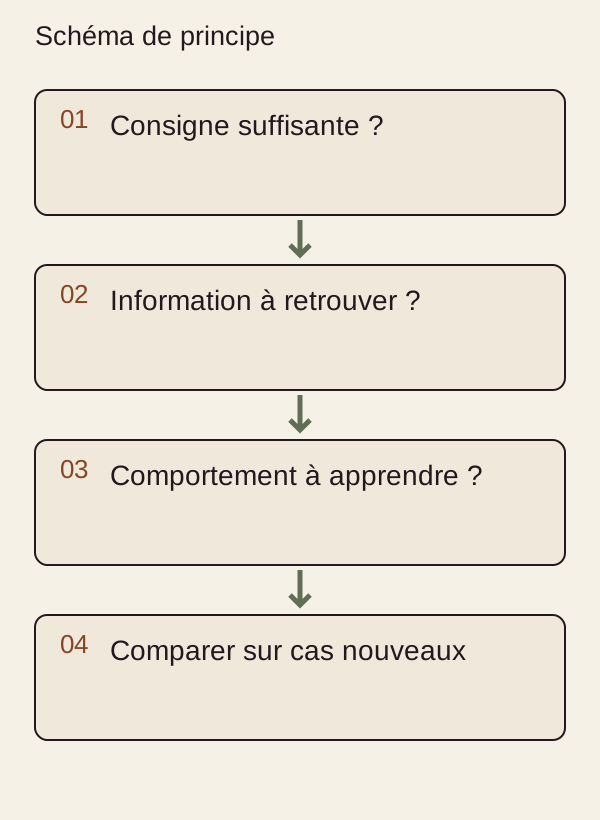
Schéma de principe original. Lecture : Consigne suffisante ? → Information à retrouver ? → Comportement à apprendre ? → Comparer sur cas nouveaux. Aucun résultat mesuré.
Adapter tous les poids n’est pas la seule option
Le fine-tuning complet ajuste l’ensemble des paramètres concernés par l’entraînement. D’autres approches réduisent le nombre de paramètres à apprendre. Le travail original LoRA, de Hu et ses coauteurs, décrit une méthode qui conserve les poids préentraînés et apprend des matrices supplémentaires de faible rang. Ces matrices représentent une modification de certains calculs du modèle. Le mot « faible » porte ici sur une propriété mathématique de cette représentation, pas sur une promesse de faible risque.
Pour comprendre l’intérêt, imaginons un grand mécanisme auquel on ajoute un réglage spécialisé plutôt que de reconstruire toutes les pièces. L’analogie explique la séparation entre base et adaptation ; elle ne décrit pas littéralement la manière dont le réseau représente le langage. L’adaptateur reste lié à une architecture et à une version de modèle. Il ne constitue pas un module universel que l’on peut déplacer sans contrôle vers n’importe quelle base.
Cette distinction compte pour la maintenance. Il faut conserver l’identité du modèle de départ, la méthode, les réglages, les données et la version de l’adaptation. Un fichier plus petit ne suffit pas à prouver un système plus simple à exploiter. Le chargement, la compatibilité, les restrictions de licence et les tests de régression font toujours partie du travail. Les résultats expérimentaux du papier LoRA portent sur ses modèles et ses tâches ; ils ne constituent pas un pourcentage de gain applicable à tout projet.
Les exemples définissent le comportement recherché
Un jeu d’entraînement n’est pas seulement une collection de « bonnes réponses ». Il matérialise une politique de décision. Pour classer des messages, il faut décrire les cas qui appartiennent à chaque catégorie, les cas qui en sont exclus et les situations où plusieurs interprétations restent possibles. Lorsque les annotateurs ne s’accordent pas, la divergence signale parfois un problème de définition du travail, plutôt qu’une insuffisance de l’outil.
La provenance des exemples doit rester visible. Un message réellement observé, une reformulation humaine et un exemple synthétique ne possèdent pas la même relation au terrain. Les mélanger sans indication rend difficile l’analyse d’un échec. Un modèle peut apprendre une présentation très régulière parce que les données ont été soigneusement nettoyées, puis rencontrer en production des abréviations, des pièces jointes absentes ou des demandes contradictoires. La qualité ne se résume donc pas à une langue impeccable.
Il faut également décider ce que le modèle ne doit pas déduire. Une information confidentielle présente dans les exemples ne devient pas inoffensive parce qu’elle est intégrée à un entraînement. La minimisation et le contrôle des droits d’utilisation interviennent avant la préparation des fichiers. Les exemples ne doivent contenir que les éléments nécessaires à l’objectif. Cette prudence n’est pas une garantie technique contre toute mémorisation ; elle réduit ce que l’on expose et clarifie les responsabilités.
La grille ci-dessous propose une organisation éditoriale du dossier d’apprentissage. Elle n’est pas une norme ni le résultat d’un essai. Son rôle est de rendre les désaccords discutables avant de payer un entraînement.
| Champ de l’exemple | Question à résoudre | Trace à conserver |
|---|---|---|
| Situation | Quelle décision attend-on exactement ? | Description de la tâche |
| Entrée | Le contexte fourni existe-t-il au moment réel de la décision ? | Origine et transformation |
| Réponse attendue | Qui la valide et selon quelle règle ? | Règle d’annotation |
| Exception | Quand faut-il demander une précision ? | Cas limite commenté |
| Droit d’usage | Peut-on employer cette donnée pour apprendre ? | Autorisation applicable |
| Séparation | Cet exemple ressemble-t-il à un cas de test ? | Groupe ou famille d’origine |
Garder un examen que l’apprentissage n’a pas vu
Un entraînement peut devenir meilleur sur ses exemples sans mieux traiter de nouvelles situations. C’est pourquoi l’évaluation doit porter sur un ensemble séparé. La séparation se pense au niveau de la situation réelle : des reformulations du même échange, des documents presque identiques ou des messages d’un même dossier peuvent transmettre la réponse d’un ensemble à l’autre. Tirer les lignes au hasard ne résout pas nécessairement cette proximité.
Le jeu de développement sert à choisir les réglages et à comprendre les erreurs. Le jeu de test final sert à apprécier la solution retenue. Si l’équipe le consulte constamment pour corriger le modèle, il devient progressivement un outil de développement. Conserver un dernier ensemble réellement réservé protège contre une conclusion trop optimiste. La taille nécessaire dépend de la diversité des cas et de la précision recherchée ; annoncer un nombre universel serait trompeur.
Il faut mesurer ce qui représente le travail, plutôt que ce qui est facile à compter. Un format valide peut contenir la mauvaise catégorie. Une bonne catégorie peut être accompagnée d’une justification inventée. Une réponse correcte peut exposer une donnée qu’elle ne devait pas utiliser. La grille d’évaluation doit donc séparer ces propriétés. Un score agrégé est utile pour résumer, mais les erreurs graves et les catégories difficiles doivent rester visibles.
Comparer exige enfin de maintenir les conditions communes : mêmes entrées, même définition de réussite et mêmes règles de correction. Le modèle initial reçoit une consigne sérieuse, pas une version artificiellement défavorisée. Le modèle adapté ne bénéficie pas de renseignements absents de la référence. Dans cet article, aucun entraînement n’a été exécuté et aucun gain n’est annoncé. Le protocole décrit les conditions d’une comparaison à réaliser, pas les résultats d’un benchmark.
Ce qui compte après l’apprentissage
Le coût d’un modèle adapté ne se limite pas à l’exécution du calcul. Il comprend la préparation des exemples, la vérification des droits, l’annotation, les erreurs d’annotation, les évaluations et la maintenance. Une estimation doit préciser ce qui est inclus. Un tarif de fournisseur ne permet pas de déduire le coût total sans connaître le volume, la méthode et le travail humain nécessaire. De même, une réduction de longueur des consignes n’établit pas seule une économie globale.
L’adaptation peut aussi modifier des comportements que l’équipe ne cherchait pas à changer. Il faut conserver une batterie de régression sur les usages importants : refus appropriés, traitement des entrées incomplètes, langues réellement utilisées et contraintes de sortie. Une amélioration sur une catégorie ne compense pas automatiquement une dégradation critique ailleurs. Les conditions d’acceptation se définissent avant l’expérience, avec une règle explicite pour les compromis.
Une fois le modèle utilisé, les données évoluent. De nouvelles catégories apparaissent, la politique interne change, les clients emploient d’autres formulations. La première réponse n’est pas nécessairement de réentraîner. Il faut déterminer si l’erreur provient des données d’entrée, de la règle métier, de la consigne ou des paramètres. Réentraîner sur une règle devenue incohérente peut renforcer le problème. Un historique des versions et un retour vers la version précédente facilitent une correction contrôlée.
Préparer une décision, pas seulement un fichier de modèle
Avant un projet, rédiger une phrase simple aide à fixer le périmètre : « Nous cherchons à corriger tel type d’erreur, sur tels messages, selon telle règle ». Cette phrase doit être assez précise pour qu’une personne extérieure puisse construire un contre-exemple. « Rendre le modèle meilleur » n’offre pas ce contrôle. « Appliquer correctement une catégorie lorsque deux indices se contredisent » fournit déjà un problème que l’on peut examiner.
La décision peut alors reposer sur un dossier compact : référence sans entraînement, provenance des exemples, protocole de séparation, résultats par catégorie, régressions et conditions de retour arrière. Le choix technique vient après cette définition. LoRA ou une adaptation complète sont des moyens d’apprendre ; ils ne définissent ni la qualité des données ni le niveau d’erreur acceptable.
Ce qui reste à démontrer est propre à chaque usage : l’adaptation améliore-t-elle les erreurs qui comptent sur des cas nouveaux, sans créer de dégradation incompatible avec le travail ? Tant que cette comparaison n’est pas réalisée, le fine-tuning demeure une option technique documentée. Lorsqu’elle l’est, on peut discuter d’un résultat situé, avec ses conditions et ses limites, plutôt que d’une promesse générale de spécialisation.
Pour approfondir cette distinction, consulter le dossier Distillation : comment un petit modèle apprend d’un plus grand.
Sources
- Hugging Face, documentation Transformers, « Fine-tuning », branche main consultée le 19 octobre 2026 ; capture locale conservée, aucun exemple logiciel exécuté.
- Edward Hu et coauteurs, « LoRA: Low-Rank Adaptation of Large Language Models », version 2 du 16 octobre 2021, sections 1 à 4 consultées le 19 octobre 2026.