La mémoire peut-elle limiter une puce IA plus que son calcul ?
Édition : Célia
Capacité, bande passante et latence : comprendre quand les données limitent le calcul IA, avec un exemple Roofline explicitement fictif.
Oui. Une puce capable d’effectuer beaucoup d’opérations peut attendre les données nécessaires pour les exécuter. La capacité mémoire détermine ce qui peut être conservé ; la bande passante décrit le volume transférable par unité de temps ; la latence concerne le délai d’un accès. Ces trois propriétés répondent à des questions différentes. Pour comprendre la performance d’une application d’intelligence artificielle, il faut donc relier ses calculs à ses déplacements de données. Une fiche indiquant seulement un maximum d’opérations par seconde ne permet pas de prévoir le temps d’exécution d’un modèle.
Trois questions derrière le mot mémoire
La capacité répond à « combien peut-on garder ? ». Un modèle, ses données intermédiaires et les autres éléments de l’application doivent trouver une place dans les mémoires utilisées. Dépasser la capacité disponible peut imposer de modifier la configuration ou de déplacer des éléments vers une autre mémoire. Cela ne renseigne pas encore sur la vitesse à laquelle les données seront accessibles.
La bande passante répond à « combien peut-on transférer pendant une durée donnée ? ». Elle se mesure par exemple en octets par seconde. Une mémoire de grande capacité peut offrir un débit insuffisant pour certains calculs. Inversement, un débit élevé ne permet pas de conserver un ensemble de données plus grand que la capacité. Mélanger ces deux notions conduit à choisir un équipement sur le mauvais critère.
La latence répond à « combien de temps faut-il attendre cet accès ? ». Une application peut être sensible à une suite de dépendances, même si son volume total de données reste modeste. Lorsque l’opération suivante dépend du résultat de la précédente, tout ne peut pas être accéléré en transférant davantage de données en parallèle. Le débit maximal ne résume donc pas tous les délais rencontrés.
Le calcul doit recevoir ses entrées
Une opération arithmétique utilise des nombres et produit un résultat. Dans un réseau neuronal, ces nombres peuvent être des poids, des activations ou des données intermédiaires. Il faut les placer à la portée des unités de calcul et parfois conserver le résultat pour une autre opération. L’activité utile dépend de la coopération entre calcul, mémoire et logiciel.
On peut imaginer un atelier dont les machines attendent des pièces. Ajouter des machines ne résout pas toujours le problème si la livraison reste inchangée. Mais l’analogie a une limite : un processeur peut réutiliser une donnée plusieurs fois et possède plusieurs niveaux de mémoire. Son organisation permet parfois de réduire les transferts au lieu de simplement augmenter leur débit.
Le modèle Roofline présenté par Berkeley Lab rassemble précisément débit de calcul, bande passante et localité des données. Il sert à comprendre une enveloppe de performance possible. Ce n’est pas un chronomètre universel : il organise les limites et aide à identifier ce qui mérite une mesure détaillée.
L’intensité arithmétique relie les deux côtés
L’intensité arithmétique est le rapport entre le nombre d’opérations et la quantité de données déplacées, pour un niveau de mémoire défini. Si beaucoup d’opérations sont réalisées avec peu de transferts, l’application peut mieux exploiter les unités de calcul. Si chaque opération demande de nouvelles données, le déplacement risque de peser davantage.
Le choix du niveau de mémoire est essentiel. Compter les échanges avec la mémoire principale n’est pas la même chose que compter ceux qui ont lieu dans un cache proche des unités de calcul. Une donnée chargée une fois peut être réutilisée plusieurs fois localement. Une estimation qui ignore cette réutilisation peut décrire un trafic différent du trafic réel.
Berkeley Lab souligne aussi le rôle des accès, des caches et du placement des données. Un modèle théorique utile ne dispense donc pas d’observer l’application. Il donne une question précise : la performance est-elle compatible avec les limites attendues, ou un autre facteur l’abaisse-t-il ? La réponse peut concerner le logiciel autant que le matériel.
Un petit calcul pour comprendre une borne
Considérons un système entièrement fictif capable d’atteindre cent milliards d’opérations par seconde et de déplacer vingt milliards d’octets par seconde au niveau étudié. Pour une tâche effectuant deux opérations par octet transféré, la borne liée aux données est de quarante milliards d’opérations par seconde. Elle est plus basse que la capacité de calcul annoncée.
Si la même machine traite une tâche réalisant dix opérations par octet, la borne liée aux transferts devient deux cents milliards d’opérations par seconde. Le calcul maximal, fixé à cent milliards dans notre hypothèse, constitue alors la borne la plus basse. L’exemple illustre le changement de limite lorsque le travail change ; il ne démontre la performance d’aucune puce existante.
Le calcul conserve la plus petite des deux valeurs : débit maximal de calcul et produit de la bande passante par l’intensité arithmétique. Il suppose des conditions idéales simplifiées. Les durées de lancement, les dépendances, les accès non efficaces et les autres opérations ne disparaissent pas dans une application réelle. Une borne de débit ne doit pas être présentée comme un résultat mesuré.
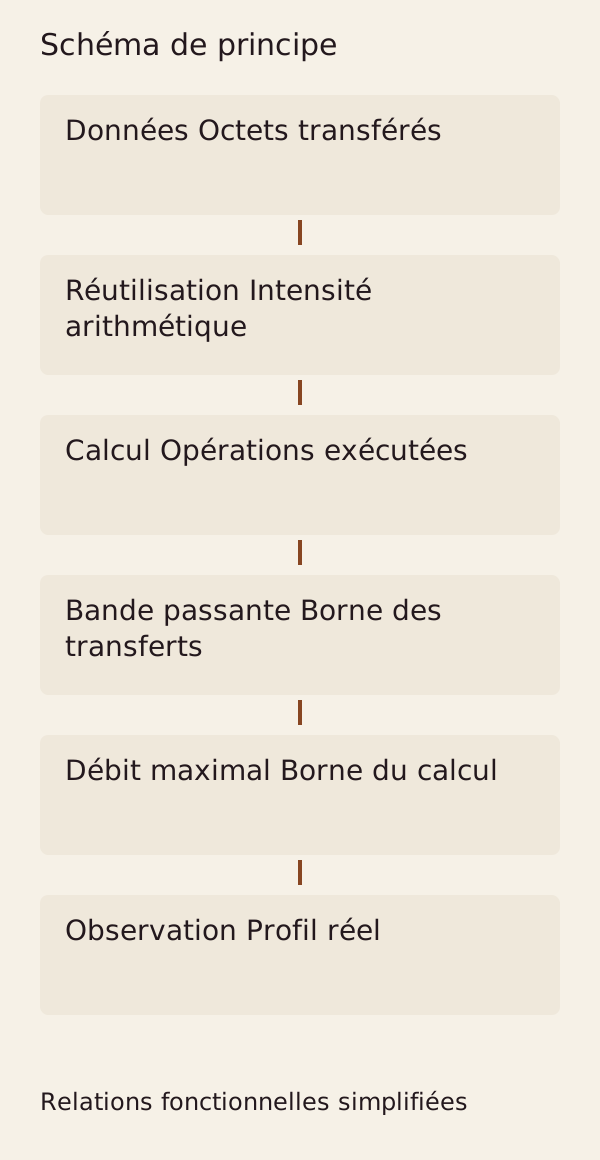
Le schéma met en relation les données transférées, leur réutilisation et les unités de calcul. L’équivalent textuel est le calcul précédent. Les valeurs de l’exemple sont conservées dans un script et un fichier de résultats afin que leur origine fictive et leur formule restent vérifiables.
Pourquoi la forme des opérations change le résultat
La documentation NVIDIA sur les multiplications de matrices explique comment les dimensions du problème influencent son intensité arithmétique. Multiplier des matrices ne produit pas toujours le même rapport entre calcul et déplacements. Les possibilités de réutilisation varient avec les dimensions et avec la manière dont l’opération est organisée.
NVIDIA décrit notamment un découpage en blocs, ou tiles, qui permet de traiter des portions du résultat en réutilisant des données. Des blocs plus grands peuvent améliorer cette réutilisation, mais ils peuvent aussi réduire le nombre de tâches disponibles en parallèle pour une taille de problème donnée. Le choix n’est donc pas « toujours plus grand » : il existe un compromis entre réutilisation et occupation du matériel.
Cette documentation est utilisée pour expliquer un mécanisme, pas pour généraliser les résultats chiffrés d’un ancien accélérateur à tous les matériels actuels. Le fournisseur précise lui-même que le raisonnement simplifié ne couvre pas tous les détails d’implémentation. Les versions des bibliothèques et les formats numériques participent également au comportement observé.
Pour une application d’IA, cette distinction signifie que le nom du modèle ne suffit pas. Le nombre d’entrées traitées ensemble, leurs dimensions et l’organisation du calcul changent le travail effectivement exécuté. Une mesure sur une charge différente peut être authentique et pourtant peu informative pour l’usage envisagé.
La proximité aide seulement si les données sont bien utilisées
Placer certaines données plus près du calcul peut réduire des déplacements coûteux. Les caches remplissent notamment cette fonction en conservant des éléments susceptibles d’être réutilisés. Mais leur présence n’assure pas que l’application en profite. La disposition des données et l’ordre des accès influencent ce qui reste disponible au moment utile.
Berkeley Lab mentionne les défauts de cache et les transferts superflus parmi les facteurs qui abaissent la performance. Cela invite à examiner le logiciel avant d’attribuer toute lenteur à un manque de puissance brute. Une organisation qui recharge inutilement les mêmes données peut gaspiller une bande passante pourtant élevée.
Sur les systèmes comportant plusieurs zones de mémoire ou plusieurs processeurs, l’emplacement des données peut également compter. Une application ne rencontre pas forcément les mêmes caractéristiques pour tous ses accès. Parler d’une unique « vitesse mémoire » peut masquer cette diversité. La mesure doit préciser quel chemin est utilisé et ce qui circule effectivement dessus.
Diagnostiquer avant d’acheter
Un symptôme ne prouve pas immédiatement sa cause. Une faible utilisation apparente des unités de calcul peut provenir des accès mémoire, mais aussi d’autres attentes ou d’une charge trop petite. La bonne démarche consiste à décomposer le temps d’exécution, observer les transferts et comparer les hypothèses au comportement réel.
Un protocole utile conserve la version du modèle, les formats numériques, les dimensions des entrées et les versions logicielles. Il distingue les premières exécutions des suivantes si des chargements ou des préparations changent le comportement. Il précise aussi la métrique recherchée : temps de réponse d’une requête, débit d’un service ou durée d’un lot ne décrivent pas la même priorité.
Le tableau suivant organise les preuves à demander. Il ne constitue ni un classement d’accélérateurs ni une recommandation d’achat. Son objectif est d’éviter qu’une caractéristique isolée soit utilisée pour répondre à une question plus large qu’elle.
| Question | Indicateur pertinent | Limite de l’indicateur |
|---|---|---|
| Les données tiennent-elles ? | Capacité disponible et mémoire réellement occupée | Ne prévoit pas le débit |
| Les transferts sont-ils suffisants ? | Trafic et bande passante au niveau étudié | Ne décrit pas toutes les latences |
| Les accès arrivent-ils à temps ? | Délais et dépendances observés | Ne résume pas la quantité transférée |
| Le calcul est-il bien exploité ? | Profil des opérations et occupation | Une faible occupation ne prouve pas seule la cause |
| Le service atteint-il son objectif ? | Temps et débit sur charge représentative | Un test différent ne se transpose pas automatiquement |
Une optimisation peut déplacer la limite
Si une modification réduit les transferts, la performance peut finir par rencontrer la limite du calcul. Cela ne signifie pas que l’optimisation a échoué : elle a changé le facteur qui dominait. Continuer à améliorer la même caractéristique peut alors apporter moins de bénéfice. Le diagnostic doit être refait après un changement important, au lieu de conserver indéfiniment la première explication de la lenteur.
La qualité du résultat doit également rester comparable. Réduire la taille numérique des données change leur représentation ; cela peut alléger la mémoire, mais exige une vérification de l’effet sur l’application. Un débit plus élevé obtenu avec une sortie moins précise ne constitue pas automatiquement une amélioration pour le lecteur. Le protocole doit fixer la qualité attendue avant de comparer les temps, afin que les gains techniques correspondent à un service effectivement équivalent.
Ce qui compte : une mémoire ne se résume ni à sa capacité ni à un chiffre de débit. L’application crée un profil de calcul et de transferts ; le matériel et le logiciel doivent répondre à ce profil. L’intensité arithmétique aide à relier ces deux mondes sans prétendre remplacer une mesure.
Ce qui reste à démontrer : nous n’avons testé aucun accélérateur dans ce dossier. Le calcul illustratif explique une borne, pas une performance commerciale. Avant une décision, il faut mesurer la charge visée et vérifier qu’un changement proposé agit bien sur sa limite réelle plutôt que sur une caractéristique impressionnante mais secondaire.
Sources et calcul reproductible
- Berkeley Lab, The Roofline Model: Visualizing and Optimizing Performance, lecture le 19 octobre 2026, modèle et limites d’interprétation.
- NVIDIA, Matrix Multiplication Background User’s Guide, section Math and Memory Bounds et implémentation, version affichée 2023, lecture le 19 octobre 2026.
calcul.pyetcalcul-resultats.json: exemple numérique fictif, aucune mesure de matériel.