Open source et poids ouverts : comment lire la licence d’un modèle IA
Édition : Célia
Distinguer poids ouverts et open source, puis lire les composants, les permissions et les conditions d’un modèle.
Pouvoir télécharger les poids d’un modèle ne suffit pas à savoir ce que l’on peut légalement en faire ni comment il a été construit. Il faut distinguer l’accès aux fichiers, les permissions accordées et les informations permettant de modifier le système. La définition de l’Open Source Initiative fournit un cadre précis, mais elle n’est pas une décision de justice. Pour choisir un modèle, examiner séparément les poids, le code, les données documentées et les conditions applicables donne une lecture beaucoup plus utile qu’une étiquette « ouvert » ou « propriétaire » prise isolément.
Un modèle est un assemblage de composants
Les poids sont les paramètres numériques appris. L’architecture décrit l’organisation des calculs et le code d’inférence permet de les exécuter. D’autres éléments, comme le tokenizer qui découpe le texte, peuvent être indispensables à l’utilisation correcte. Un dépôt qui donne accès à l’un de ces éléments ne donne pas nécessairement accès aux autres dans les mêmes conditions.
Le code d’entraînement et les informations sur les données répondent encore à une autre question : comment le système a-t-il été obtenu ? Exécuter un modèle déjà préparé et reproduire son apprentissage sont deux capacités différentes. Une publication peut rendre la première possible sans fournir les éléments suffisants pour la seconde. Ce constat décrit une limite de reproductibilité ; il ne permet pas, à lui seul, de conclure que le modèle fonctionne mal.
Une fiche de modèle aide à identifier ces relations. La documentation Hugging Face sur les model cards prévoit notamment des métadonnées de licence et de modèle de base. Ces champs facilitent la découverte et la compréhension d’un dépôt. Ils restent des déclarations à confronter aux fichiers et aux termes effectivement fournis. Une étiquette dans une interface n’est pas un substitut au texte de licence.
La distinction devient importante avec les modèles dérivés. Un adaptateur, une quantification ou une fusion peut ajouter une nouvelle couche de conditions et de provenance. Le nom du dépôt dérivé ne doit pas faire oublier le modèle initial. Il faut conserver la chaîne de dépendance et examiner les documents applicables à chaque composant nécessaire au déploiement.
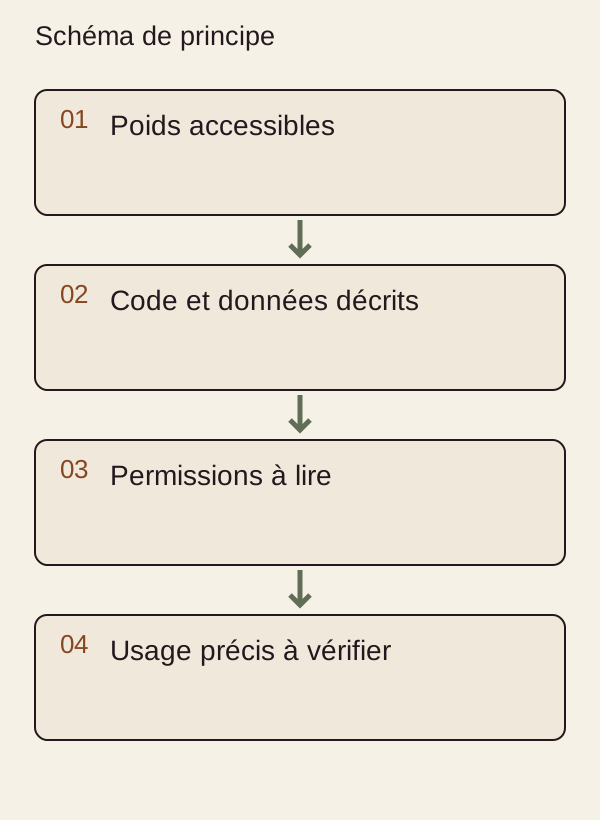
Schéma de principe original. Lecture : Poids accessibles → Code et données décrits → Permissions à lire → Usage précis à vérifier. Aucun résultat mesuré.
Ce que demande la définition de l’OSI
La version 1.0 de l’Open Source AI Definition décrit des libertés d’utilisation, d’étude, de modification et de partage. Elle demande aussi l’accès à une forme permettant de modifier le système. Pour les systèmes d’apprentissage automatique, cette forme comprend des informations sur les données, le code et les paramètres. Les exigences portent donc sur davantage que la disponibilité d’un fichier de poids.
Le volet relatif aux données mérite une lecture attentive. La définition demande une information suffisamment détaillée pour qu’une personne compétente puisse construire un système substantiellement équivalent. Elle décrit notamment la provenance, la sélection, l’annotation et le traitement des données, ainsi que les moyens d’obtenir celles qui sont accessibles. Elle ne se résume pas à une obligation simpliste de publier en ligne chaque donnée brute, y compris celles qui ne peuvent être partagées.
Ce cadre donne un sens précis au terme dans l’approche de l’OSI. Il n’efface pas les débats sur l’ouverture, la protection des données ou les droits attachés aux paramètres. La définition indique elle-même que les mécanismes juridiques applicables aux poids peuvent soulever des questions. Il faut donc distinguer une conformité à ce cadre, une affirmation commerciale et une conclusion juridique sur un usage particulier.
Le mot « ouvert » employé sans précision peut désigner un accès gratuit, des poids téléchargeables, un code inspectable ou un ensemble plus complet de libertés. Plutôt que d’exiger que ce mot résolve toutes les questions, demander un tableau des éléments fournis permet de comprendre l’offre. Cette démarche évite autant de surestimer l’ouverture que de rejeter un système utile pour une raison mal formulée.
Lire ce qui est permis, puis ce qui est imposé
La première lecture d’une licence cherche les actes autorisés : exécuter, modifier, redistribuer, intégrer à un service et éventuellement entraîner un dérivé. La seconde cherche les obligations et restrictions : attribution, conservation des notices, conditions de redistribution ou limites d’usage. Leur effet dépend du texte exact. Il serait trompeur d’attribuer les mêmes permissions à tous les modèles dont les fichiers sont publics.
Les conditions peuvent aussi différer selon la manière d’accéder au modèle. Utiliser un service hébergé implique ses propres termes, alors que télécharger un modèle implique les documents du dépôt et ceux des composants nécessaires. Il faut lire le parcours réellement choisi. Une autorisation d’utiliser une interface ne prouve pas que l’on peut redistribuer les poids ; une licence de poids ne décrit pas forcément les modalités d’un service tiers.
La CNIL, dans ses questions-réponses sur l’IA générative, recommande de partir du besoin et d’examiner notamment la licence et les informations relatives aux données d’entraînement. Cette recommandation remet la décision dans son contexte : une licence permissive ne dispense pas de traiter les autres obligations du projet, notamment lorsque des données personnelles sont utilisées.
Une analyse juridique particulière peut être nécessaire pour un déploiement sensible ou une redistribution. Cet article ne tranche pas un contrat ni un conflit de droits. Il fournit une méthode de préparation : réunir les documents, identifier les actes envisagés et noter les ambiguïtés. Une question précise accompagnée des textes applicables est plus exploitable qu’une demande générale de confirmation que le modèle est « libre ».
Une grille pour comparer deux dossiers
Le tableau suivant ne compare pas des produits réels. Il propose une fiche que l’on peut remplir à partir de deux dépôts identifiés, sans transformer une information absente en interdiction supposée. Chaque réponse doit renvoyer au document et à sa version.
| Élément | Question à documenter | Preuve utile |
|---|---|---|
| Poids | Quels fichiers et quelle révision ? | Dépôt et empreinte |
| Code | Inférence et entraînement disponibles ? | Répertoires et licences |
| Données | Provenance et traitement décrits ? | Fiche ou documentation |
| Usage prévu | Les actes envisagés sont-ils couverts ? | Clauses applicables |
| Dérivés | Quelles obligations sont transmises ? | Conditions de modification |
| Distribution | Quelles notices conserver ? | Licence et fichiers associés |
| Service | Quels termes s’ajoutent à l’hébergement ? | Contrat du service utilisé |
Le résultat peut être « documenté », « à clarifier » ou « non applicable ». Il ne faut pas remplir une case incertaine par une conclusion plausible. Une documentation manquante réduit ce que l’on sait ; elle ne prouve pas automatiquement une restriction ou une absence de droits. La question doit être adressée au bon interlocuteur avant une action qui dépend de sa réponse.
L’identité de la version compte autant que le titre de la licence. Une page peut évoluer, un dépôt peut remplacer un fichier et un modèle peut changer de base. Conserver la date de consultation et les documents pertinents permet d’expliquer la décision prise. Cette archive ne remplace pas une nouvelle vérification lorsque l’on change de version ou d’usage.
L’ouverture ne mesure pas la qualité du modèle
Un modèle peut être largement ouvert et mal adapté à une tâche. Un autre peut être fermé et correctement documenté sur certaines performances. Les permissions et les capacités sont des dimensions différentes. La sélection technique doit conserver ses propres critères : qualité sur les cas visés, coûts d’exécution, contraintes matérielles et comportement face aux informations manquantes.
L’accès aux poids peut faciliter certaines inspections et certains déploiements, mais il ne garantit pas une compréhension exhaustive du comportement. Lire le code ne suffit pas à expliquer chaque réponse d’un réseau entraîné. La disponibilité des données et des procédures peut améliorer la reproductibilité sans rendre toute reproduction réalisable avec les ressources de n’importe quelle équipe. Il faut décrire ce qui est possible et ce qui a effectivement été réalisé.
De même, héberger localement ne signifie pas que tous les risques disparaissent. La chaîne logicielle, les fichiers téléchargés, les données reçues et les permissions de l’application restent à contrôler. Une licence traite des droits ; elle n’est pas un audit de sécurité. Un choix raisonnable examine ces questions sans leur demander de se remplacer mutuellement.
Préparer la décision et sa maintenance
Une organisation peut commencer par écrire son scénario d’usage : traitement interne, service accessible à des clients, modification du modèle ou redistribution d’un dérivé. Cette description détermine les clauses à examiner. Elle doit être assez précise pour identifier les composants réellement distribués et les données traitées. Un modèle simplement testé dans un laboratoire et un modèle intégré à une offre commerciale n’impliquent pas le même dossier.
Le dossier retenu devrait réunir les versions, les licences, les notices, les dépendances et les questions non résolues. Un responsable doit savoir ce qui déclenche une relecture : nouveau modèle de base, changement de fournisseur, mise à jour de termes ou extension de l’usage. Sans cette responsabilité, une vérification correcte au départ peut devenir une trace ancienne que personne ne confronte au système actuel.
Il faut aussi prévoir la sortie. Peut-on continuer à exécuter la version retenue ? Peut-on exporter les éléments produits ? Quels composants devront être remplacés si le service ou la politique change ? Ces questions de réversibilité ne reçoivent pas une réponse uniforme du mot open source. Elles se vérifient dans les conditions techniques et documentaires du projet.
Ce qui compte est de remplacer l’étiquette par des propriétés vérifiables. Les poids peuvent être accessibles, les droits plus ou moins larges, les données plus ou moins documentées et la reproduction plus ou moins possible. La définition OSI aide à organiser une partie de cette lecture. La décision finale reste liée à un modèle précis, à une version et à un usage explicite, sans promesse juridique générale.
Pour éviter les malentendus dans une équipe, une phrase de synthèse peut séparer explicitement les constats : « Les poids de cette révision sont téléchargeables ; les conditions autorisent les actes indiqués dans notre dossier ; la procédure d’entraînement reste partiellement documentée ». Cette formulation paraît moins spectaculaire qu’un label, mais elle permet à chaque responsable de vérifier sa partie. Elle évite aussi qu’un avantage technique, comme l’exécution locale, soit confondu avec une conclusion sur les droits, la transparence ou la qualité scientifique du modèle retenu.
Pour approfondir cette distinction, consulter le dossier Comment lire la fiche d’un modèle avant de l’intégrer.
La lecture peut se terminer par une fiche de décision courte : composant concerné, version, texte applicable, usage prévu et question encore ouverte. Si une condition reste ambiguë, la bonne sortie est cette question formulée précisément, accompagnée du passage qui la provoque. Demander si un usage commercial est possible n’est pas équivalent à demander si une redistribution modifiée est permise. Cette séparation aide la personne chargée de la validation à répondre au cas réel. Elle évite également qu’une conclusion portant sur un composant soit réutilisée sans examen pour tout le système.
Sources
- Open Source Initiative, « Open Source AI Definition », version 1.0, consultée le 19 octobre 2026.
- Hugging Face, « Model Cards », documentation consultée le 19 octobre 2026.
- CNIL, questions-réponses sur l’utilisation de l’IA générative, 18 juillet 2024, sections 3 et 4 consultées le 19 octobre 2026.