Dérive d’un système IA : pourquoi un outil peut devenir moins fiable
Édition : Sophie
Distinguer dérive des données, changement métier et incident logiciel, puis organiser une surveillance qui mène à une action.
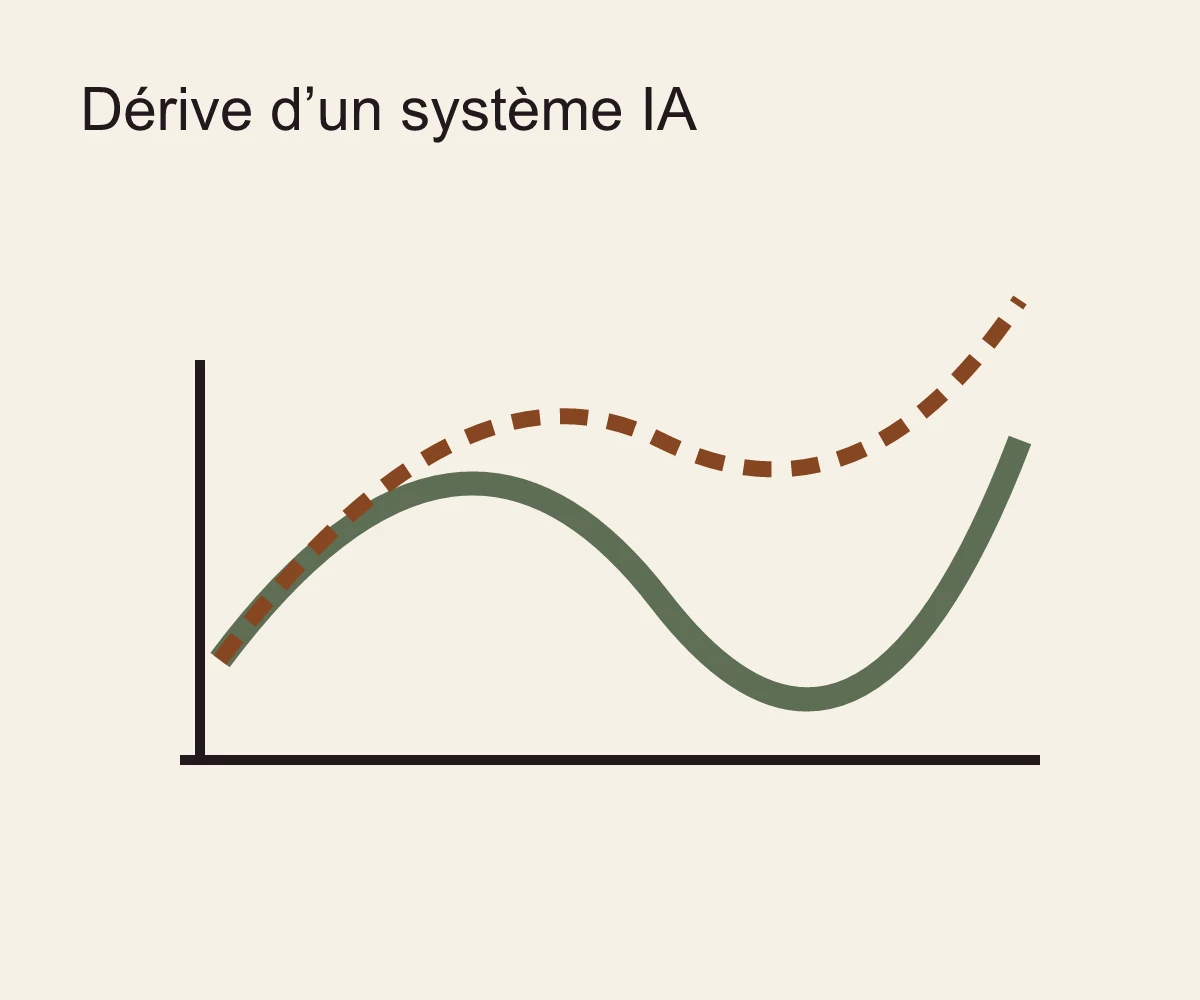
Un système peut perdre en fiabilité sans que ses paramètres aient changé. Les demandes, les documents, les catégories ou les règles métier peuvent évoluer autour de lui. On parle de dérive lorsque certaines distributions ou relations pertinentes changent dans le temps. Mais une panne de connecteur ou une mauvaise mise à jour n’est pas automatiquement une dérive statistique. Pour agir correctement, il faut distinguer ces causes, conserver une référence et surveiller les erreurs qui comptent. Une alerte signale un écart à examiner ; elle ne prouve pas à elle seule que le modèle doit être réentraîné.
Le monde continue après le premier test
Lors de la préparation, un modèle est évalué sur des données choisies à une période donnée. En production, il reçoit d’autres données. Les habitudes des utilisateurs peuvent évoluer, de nouveaux produits apparaître et les formats de documents changer. Une règle apprise sur les cas anciens peut alors rencontrer des situations différentes. Le modèle n’a pas besoin de « vieillir » physiquement pour devenir moins adapté.
La documentation Google Cloud sur Model Monitoring décrit la comparaison de distributions d’entrées ou de sorties avec une référence. Elle illustre comment des changements dans les données peuvent motiver une réévaluation. Cette documentation concerne des fonctionnalités précises, notamment des modèles tabulaires ; ses indicateurs ne doivent pas être présentés comme une solution universelle pour toutes les applications génératives.
Une différence dans les entrées n’implique pas nécessairement une baisse de qualité. Une boutique peut recevoir davantage de demandes dans une catégorie que le modèle traite correctement. À l’inverse, une relation importante peut changer sans modification spectaculaire d’un indicateur global. Il faut donc relier l’observation statistique à la tâche et, lorsque c’est possible, aux résultats réellement obtenus.
Une distinction utile sépare les changements de données, les changements de relation avec la réponse attendue et les changements de logiciel. Les premiers concernent ce que le système reçoit. Les seconds concernent ce qui constitue une réponse correcte. Les troisièmes concernent le système lui-même : modèle, consigne, parseur, moteur de recherche ou connecteur. Ces phénomènes peuvent se produire ensemble, mais leur correction n’est pas interchangeable.
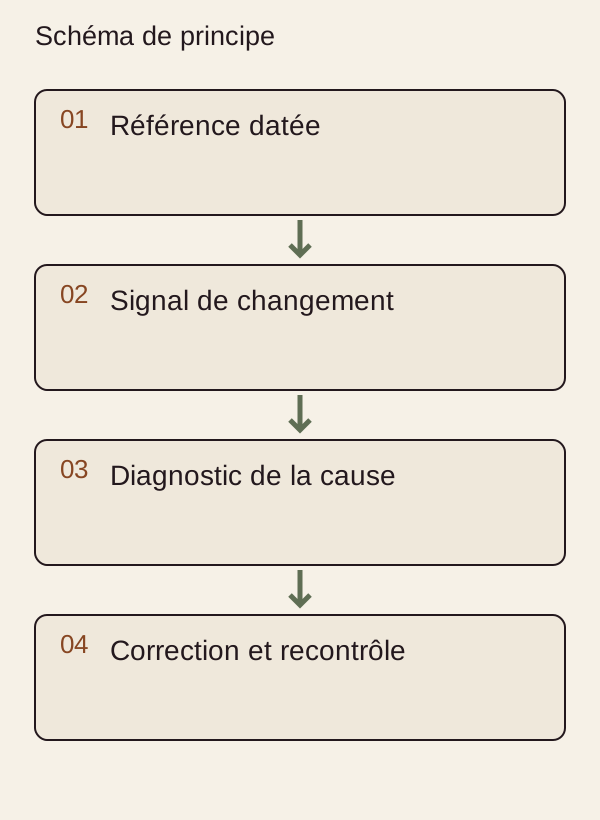
Schéma de principe original. Lecture : Référence datée → Signal de changement → Diagnostic de la cause → Correction et recontrôle. Aucun résultat mesuré.
Définir une référence que l’on peut expliquer
Une référence doit être associée à une période, un périmètre et une version du système. Comparer les demandes actuelles à des données anciennes sans connaître leur sélection peut produire une alerte difficile à interpréter. Les jours, les saisons, les canaux et les catégories peuvent influencer la composition des entrées. Il faut garder ces dimensions lorsqu’elles changent le sens de la comparaison.
La référence peut être un ensemble d’entraînement, un jeu de validation ou une période de production stable. Chacun répond à une question différente. Comparer au jeu d’entraînement examine l’écart avec ce que le modèle a appris. Comparer à une période récente examine une évolution de l’usage. Aucun choix n’est automatiquement supérieur ; il doit correspondre au risque que l’on cherche à surveiller.
Il faut aussi conserver un jeu de cas de régression, dont la réponse attendue est contrôlée. Ces cas ne remplacent pas l’observation de la production, mais ils permettent de détecter qu’une modification technique casse un comportement connu. Un historique des versions relie l’erreur au changement possible. Sans cet historique, l’équipe peut attribuer à l’évolution des utilisateurs un problème introduit par une configuration.
Les données de référence doivent rester utilisables dans le respect des droits et des règles de conservation. Les journaux de surveillance peuvent contenir des informations sensibles. Collecter tout le contenu de chaque requête n’est pas toujours nécessaire. Il faut définir les éléments utiles au diagnostic, leur accès et leur durée de conservation, plutôt que créer une copie générale de la production par défaut.
Surveiller les entrées ne suffit pas à mesurer la justesse
Un indicateur peut détecter une variation de longueur des textes, de langue ou de catégories prédites. Cela aide à repérer un changement, mais ne donne pas automatiquement le taux d’erreur. Pour savoir si une réponse est correcte, il faut une référence de vérité ou une méthode de revue. Certaines réponses ne deviennent vérifiables que plus tard ; le dispositif doit reconnaître ce délai.
La distribution des sorties peut également changer pour de bonnes raisons. Davantage de demandes de remboursement peut entraîner davantage de classifications dans cette catégorie. Une alerte sur les sorties ne permet pas de distinguer seule cette évolution d’une confusion du modèle. Les entrées, les sorties et les corrections humaines doivent être rapprochées, avec des règles d’interprétation explicites.
Pour un assistant documentaire, la qualité dépend aussi du corpus. Le modèle peut rester identique alors que des documents sont retirés, remplacés ou mal indexés. Surveiller la présence des sources, les échecs de récupération et la fraîcheur des passages devient alors pertinent. Un bon suivi du modèle ne compense pas une base documentaire qui ne contient plus l’information attendue.
Le profil NIST sur l’IA générative situe l’évaluation et la gestion des incidents dans le cycle de vie. Cette perspective invite à regarder le système dans son contexte d’usage. Elle ne fournit pas un seuil d’alerte valable pour toute application. Les conséquences des erreurs et les ressources disponibles doivent guider l’organisation du contrôle.
Construire un journal qui mène à une action
Un journal de suivi devrait permettre d’identifier un changement, son impact possible et la décision prise. Il ne suffit pas d’empiler des courbes. Pour chaque alerte, une personne doit pouvoir savoir ce qui a déclenché le signal, quel périmètre est concerné et quelles vérifications restent nécessaires. Les éléments ci-dessous constituent une proposition de grille, sans données de production inventées.
| Champ | Information à conserver | Utilité |
|---|---|---|
| Période | Début, fin et population | Comparaison interprétable |
| Version | Modèle, consigne et chaîne | Recherche de changement logiciel |
| Signal | Indicateur et référence | Origine de l’alerte |
| Cas observés | Exemples autorisés et minimisés | Analyse de l’erreur |
| Impact | Catégories et conséquences | Priorité de traitement |
| Décision | Suspendre, corriger ou observer | Responsabilité explicite |
| Recontrôle | Preuve après intervention | Vérification de la résolution |
Une alerte sans destinataire ni procédure risque de devenir un bruit de fond. À l’inverse, une procédure trop lourde pour chaque variation mineure peut épuiser l’équipe. Le dispositif doit distinguer les écarts à surveiller des incidents exigeant une suspension. Ces catégories doivent être définies avant l’urgence, puis ajustées à partir des événements réellement observés.
Diagnostiquer avant de réentraîner
Prenons un scénario fictif : un assistant classe mal des messages après l’ajout d’un nouveau canal. Les messages de ce canal contiennent des champs absents et des abréviations particulières. Le premier contrôle porte sur la transformation des entrées. Si le connecteur a perdu un champ essentiel, réentraîner sur les sorties dégradées n’est pas la correction évidente. Il faut réparer la donnée fournie et vérifier le parcours complet.
Dans un autre cas, la politique métier change. Une demande auparavant acceptée doit désormais être transmise à une équipe différente. Le modèle peut reproduire fidèlement l’ancienne règle. La correction porte alors sur la définition de la tâche, les exemples et les consignes, avec une nouvelle validation. Qualifier le modèle de moins intelligent ne décrit pas le problème : la référence de réussite a changé.
Une dérive réelle peut néanmoins justifier une adaptation. Il faut préparer de nouvelles données représentatives, conserver un test séparé et vérifier les régressions. L’ancienne version reste une référence utile tant que ses conditions sont documentées. L’amélioration doit être mesurée sur les erreurs ciblées, pas seulement sur le jeu utilisé pour préparer la correction.
Choisir les conditions de suspension
La décision de suspendre dépend des conséquences, pas uniquement de l’amplitude d’une courbe. Une erreur rare mais grave peut justifier une restriction immédiate. Une variation importante sans effet constaté peut conduire à une revue plutôt qu’à un arrêt. Les responsables doivent pouvoir expliquer ce choix et conserver les éléments qui l’ont motivé.
Il est utile de prévoir des modes dégradés explicites : retour à une règle déterministe, validation humaine renforcée ou arrêt d’une catégorie d’actions. Le système ne doit pas continuer silencieusement comme si tous ses contrôles fonctionnaient. Un message clair sur les limites rencontrées aide les utilisateurs à adapter leur confiance. La disponibilité du service et la fiabilité des réponses sont deux propriétés à suivre séparément.
Un retour arrière doit être techniquement possible et vérifié. Restaurer un ancien modèle sans restaurer la consigne ou l’index compatible peut laisser le problème intact. Il faut penser en versions de système, pas seulement en fichiers de poids. Après correction, le contrôle porte sur les cas ayant révélé l’incident et sur les autres comportements importants, afin de ne pas déplacer l’erreur.
Une surveillance adaptée au travail réel
Le rythme de contrôle dépend de la fréquence des usages, des changements et du délai acceptable de détection. Une cadence universelle serait artificielle. Une application peu utilisée peut manquer d’exemples pour une analyse statistique fréquente ; une application à conséquences fortes peut exiger des vérifications rapides même sur peu de cas. La méthode doit expliquer ce que les données permettent effectivement de mesurer.
Ce qui compte est de conserver un lien entre signal, erreur et action. Une surveillance utile ne promet pas de détecter tous les problèmes avant qu’ils arrivent. Elle rend visibles certains changements, permet de les interpréter et organise une réponse. Le premier déploiement n’est donc pas la fin de l’évaluation : c’est le début d’une observation dont les références, les limites et les décisions doivent rester traçables.
Un responsable peut préparer un exercice simple de diagnostic : prendre une erreur déjà expliquée, retrouver la version du système et vérifier si les journaux auraient permis de l’identifier sans connaître la réponse à l’avance. Si la trace manque, le dispositif de surveillance doit être amélioré. Si elle existe mais n’est reliée à aucune action, le problème est organisationnel. Cet exercice ne fournit pas un taux de détection général ; il vérifie une capacité concrète à enquêter sur un cas connu.
La communication aux utilisateurs fait également partie de la maintenance. Lorsqu’une catégorie est suspendue ou qu’un résultat exige une vérification supplémentaire, cette information doit être visible au bon moment. Une note technique dans un registre inaccessible ne suffit pas. Le message doit expliquer la limite pratique sans annoncer une cause encore incertaine, puis être mis à jour lorsque la résolution a été contrôlée.
Pour approfondir cette distinction, consulter le dossier Comment lire la fiche d’un modèle avant de l’intégrer.
Sources
- Google Cloud, « Introduction to Model Monitoring », documentation consultée le 19 octobre 2026, sections objectifs et calcul de dérive ; fonctions fournisseur non généralisées à tous les modèles.
- NIST, AI 600-1, juillet 2024, gestion des risques sur le cycle de vie, consulté le 19 octobre 2026.