IA multimodale : lire une image ne signifie pas comprendre un document
Édition : Pierre
Vérifier les zones d’un document, les tableaux et les légendes avant de faire confiance à une réponse multimodale.
Un système multimodal peut traiter plusieurs formes d’information, notamment du texte et des images. Cela ne signifie pas qu’il reconstitue correctement toutes les relations d’un document. Lire les caractères, retrouver l’ordre des paragraphes, associer une valeur à la bonne colonne et interpréter une légende sont des tâches distinctes. Pour utiliser une réponse documentaire, il faut vérifier les zones qui la soutiennent et conserver les ambiguïtés. La méthode proposée ici explique ces contrôles ; elle ne prétend pas mesurer les performances d’un modèle particulier ni remplacer un essai sur les documents réellement utilisés.
Un PDF peut fournir plusieurs versions de la même page
Un document numérique peut contenir du texte directement extractible, une image de page ou une combinaison des deux. Un scan demande généralement une reconnaissance de caractères, souvent désignée par le sigle OCR. Une page créée numériquement peut fournir du texte sans OCR, mais sa structure visuelle reste importante. Extraire les caractères ne suffit pas toujours à retrouver la relation entre les blocs.
La documentation du projet Docling distingue explicitement la mise en page, l’ordre de lecture, la structure des tableaux et la reconnaissance de caractères. Cette liste décrit les capacités visées par le logiciel, pas une garantie de réussite sur chaque document. Elle montre surtout que le traitement documentaire comporte plusieurs problèmes techniques que le mot « lecture » tend à réunir trop rapidement.
Une page peut ainsi être lisible à l’écran et produire un texte extrait difficile à interpréter. Deux colonnes peuvent être mêlées, une note peut être détachée de son appel et un titre peut être traité comme un paragraphe. À l’inverse, une image floue peut masquer une information que la couche textuelle conserve. Le contrôle doit donc porter sur la représentation effectivement fournie au système et sur son rapport avec la page originale.
Il faut éviter d’attribuer automatiquement toute erreur au modèle de langue final. Une valeur incorrecte peut déjà être présente dans le texte extrait. Une bonne valeur peut être mal associée à un en-tête pendant la reconstruction du tableau. Une réponse peut enfin mal interpréter une donnée correctement extraite. Identifier l’étape en cause permet de choisir une correction utile au lieu de changer de modèle au hasard.
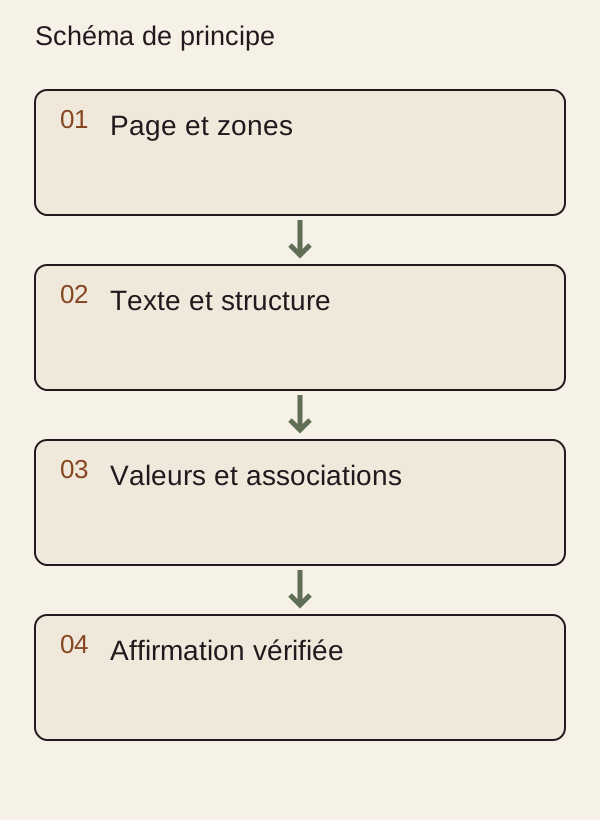
Schéma de principe original. Lecture : Page et zones → Texte et structure → Valeurs et associations → Affirmation vérifiée. Aucun résultat mesuré.
L’ordre de lecture porte une partie du sens
Une mise en page organise des relations. Un encadré peut présenter une exception ; un tableau peut être introduit par une phrase qui définit son périmètre ; une note peut modifier l’interprétation d’un résultat. Si ces éléments sont séparés, la réponse peut citer des mots exacts tout en perdant leur sens. La fidélité documentaire exige donc davantage qu’une transcription sans faute.
Prenons un document fictif à deux colonnes. La colonne de gauche décrit une procédure actuelle et celle de droite un scénario abandonné. Un extrait linéaire qui alterne les lignes peut mélanger les deux. La réponse obtenue peut paraître cohérente parce que le modèle reconstruit une histoire plausible. Le contrôle consiste à revenir aux blocs, à leurs titres et à leur position, pas seulement à rechercher les mêmes mots dans le texte.
Les en-têtes et pieds de page peuvent également se répéter à chaque page. Ils sont utiles pour identifier le document, mais peuvent perturber une extraction s’ils sont traités comme du contenu principal. Une table des matières peut être confondue avec une section. La chaîne de traitement doit conserver assez de structure pour distinguer ces rôles et permettre une vérification humaine ciblée.
L’équivalent textuel d’un schéma n’est pas nécessairement son texte visible mis bout à bout. Les flèches, les regroupements et les axes portent des relations. Une légende accessible doit décrire ces relations explicitement. Cette exigence améliore aussi la qualité des réponses documentaires : elle aide à savoir quelle relation est effectivement attestée par la figure et laquelle serait une interprétation ajoutée.
Les tableaux demandent une vérification des associations
Une cellule n’a de sens qu’avec sa ligne, sa colonne, son unité et ses éventuelles notes. Copier correctement un nombre n’est donc qu’une partie du travail. Une erreur d’alignement peut attribuer la bonne valeur au mauvais produit ou à la mauvaise période. Les cellules fusionnées et les en-têtes sur plusieurs niveaux ajoutent des relations à reconstruire.
Pour vérifier une réponse chiffrée, revenir à la zone précise et noter les intitulés complets. Une unité peut se trouver dans le titre du tableau plutôt que dans chaque cellule. Une note peut préciser qu’une valeur est estimée ou qu’un périmètre a changé. Ces informations doivent accompagner le nombre dans la réponse. Sans elles, une citation de page donne une apparence de traçabilité mais ne garantit pas une comparaison correcte.
Les valeurs absentes méritent un traitement particulier. Une cellule vide, un tiret et un zéro peuvent avoir des significations différentes selon la légende. Le système ne doit pas compléter une absence par une valeur plausible. Lorsque le document ne permet pas de trancher, la réponse doit conserver cette limite. C’est une différence essentielle entre produire un tableau propre et restituer fidèlement un tableau source.
Dans une grille de contrôle, il est utile de séparer transcription et association. La première demande si le contenu de la cellule est exact. La seconde demande s’il est relié au bon en-tête et à la bonne note. Une correction manuelle doit indiquer quelle propriété a été vérifiée. Cela évite de déclarer tout le tableau valide après avoir seulement reconnu quelques chiffres.
Un graphique n’est pas une base de données invisible
Lire un graphique exige de connaître les axes, les unités, la légende et la nature des valeurs. Une courbe représente parfois une projection, une moyenne ou une estimation. Sa forme ne permet pas de retrouver des nombres exacts au-delà de ce que le visuel fournit. Une réponse doit distinguer la lecture qualitative d’une tendance de l’extraction d’une valeur publiée.
Lorsque les données sources sont disponibles, elles constituent souvent une référence plus précise pour les calculs. Le graphique reste utile pour comprendre la présentation et les comparaisons proposées. Si seules les images sont accessibles, il faut indiquer la précision réellement permise. Inventer une décimale à partir d’un tracé serait une fausse exactitude, même si le nombre paraît raisonnable.
Une figure peut aussi contenir plusieurs panneaux dont les échelles diffèrent. Comparer directement la hauteur de deux courbes sans regarder les axes peut conduire à une conclusion erronée. Le système doit relier chaque commentaire au panneau concerné. La vérification humaine peut commencer par ces relations, avant de discuter l’explication scientifique plus générale du résultat.
Une grille de contrôle par zone
Le tableau suivant est une contribution méthodologique, sans test de performance revendiqué. Il peut être appliqué à un document public ou à un document interne autorisé. Chaque correction doit conserver la page et la zone qui la justifient.
| Zone | Risque de lecture | Contrôle concret |
|---|---|---|
| Titre | Mauvais périmètre attribué | Relier titre et section |
| Colonnes | Ordre de lecture mélangé | Comparer les blocs visibles |
| Tableau | Valeur associée au mauvais champ | Lire ligne, colonne et unité |
| Note | Exception perdue | Suivre l’appel de note |
| Graphique | Précision ou causalité inventée | Vérifier axes et légende |
| Image et texte | Versions contradictoires | Signaler l’écart sans choisir arbitrairement |
Cette méthode concentre l’effort sur la preuve nécessaire à la réponse. Il n’est pas toujours utile de relire intégralement un long rapport pour une question très précise, mais il faut vérifier que le passage sélectionné n’est pas contredit ou limité par son contexte. La zone pertinente peut inclure une légende ou une note située ailleurs sur la page.
Construire un essai interprétable
Un essai commence par un petit corpus dont les droits d’utilisation sont établis et les réponses attendues peuvent être vérifiées. Les documents doivent couvrir les difficultés réellement importantes : scans, colonnes, tableaux, figures et informations absentes. Les questions sont préparées avant de regarder les sorties, pour éviter de ne retenir que les démonstrations réussies.
Il faut conserver les fichiers d’entrée, leur version, la méthode d’extraction, le modèle éventuel et les réglages utiles. Les sorties brutes et les corrections sont enregistrées séparément. Une réponse corrigée manuellement ne doit pas être présentée comme la sortie initiale du système. La distinction permet de mesurer le travail de vérification nécessaire, qui fait partie du coût réel d’utilisation.
La grille de notation doit reconnaître plusieurs types d’erreur : omission, invention, transcription, association et interprétation. Un taux global sans cette décomposition peut masquer un problème important. Le nombre de documents et de questions doit être indiqué avec le résultat. Une réussite sur quelques pages ne démontre pas une fiabilité générale, et un échec isolé n’explique pas à lui seul toutes les limites d’une technologie.
Le NIST, dans son profil sur l’IA générative, décrit notamment le risque de réponses erronées présentées avec assurance. Cette prudence vaut aussi pour la lecture multimodale. Une réponse détaillée peut dépasser ce que le document soutient. L’évaluation doit vérifier la correspondance avec la source, pas seulement la fluidité ou le degré de confiance exprimé.
Quand l’image et le texte se contredisent
Une divergence doit être traitée comme une information à examiner. Elle peut provenir d’une couche textuelle ancienne, d’une erreur de conversion ou d’une modification du document. Choisir automatiquement la version qui semble la plus claire ne suffit pas. Il faut identifier le fichier, la zone et la nature du désaccord, puis rechercher une version de référence si la décision l’exige.
Pour une tâche sensible, le système peut demander une vérification humaine ou refuser de conclure sur la valeur litigieuse. Cette abstention localisée est plus utile qu’une réponse générale affirmant que tout le document est illisible. Elle explique précisément ce qui manque. L’utilisateur peut alors fournir une meilleure copie ou consulter la source originale.
Ce qui compte est de préserver la chaîne entre la question, la zone documentaire et l’affirmation finale. La multimodalité élargit les formes d’information accessibles ; elle ne supprime pas le travail d’interprétation et de contrôle. Un bon usage sait dire ce qui a été lu, comment cela a été vérifié et où l’incertitude commence. C’est cette traçabilité qui permet de transformer une démonstration visuelle en outil réellement utilisable.
Pour approfondir cette distinction, consulter le dossier Sécuriser une base documentaire pour un assistant IA.
Une page fictive pour repérer les mauvaises associations
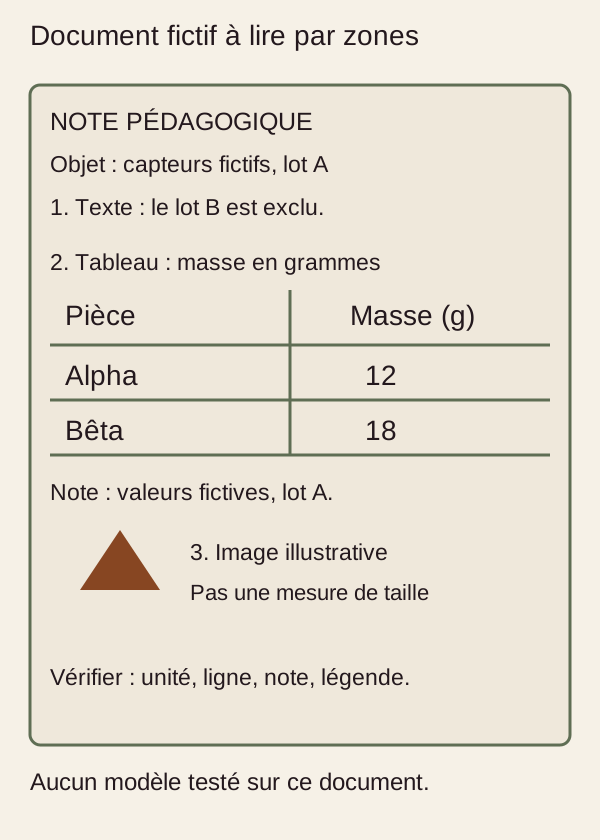
Ce document est entièrement inventé pour l’explication. Aucun modèle n’a été exécuté dessus et aucun taux de réussite n’en est déduit. Le texte précise que le lot B est exclu. Le tableau décrit seulement le lot A : Alpha pèse 12 grammes et Bêta 18 grammes. Ces nombres fictifs servent à comprendre l’association entre une ligne, une colonne et une unité, sans décrire un produit réel.
L’image triangulaire est une illustration sans échelle. Elle ne permet donc pas de calculer la taille d’une pièce. Une réponse correcte à la question « quelle masse pour Bêta ? » doit conserver 18 et l’unité gramme ; elle ne doit ni emprunter la valeur d’Alpha, ni généraliser au lot B. La note sous le tableau fait partie de l’information à conserver. Cette lecture humaine constitue l’équivalent textuel du visuel, pas un résultat de benchmark.
| Zone du document fictif | Information à conserver | Confusion à éviter |
|---|---|---|
| Texte | Lot B exclu | Étendre les valeurs à tous les lots |
| Tableau | Alpha : 12 g ; Bêta : 18 g | Inverser les lignes ou perdre l’unité |
| Note | Valeurs fictives, lot A | Présenter les nombres comme des mesures réelles |
| Image | Triangle sans échelle | Déduire une dimension du dessin |
Sources
- Docling, documentation officielle, fonctionnalités et traitement documentaire, consultée le 19 octobre 2026. Capacités déclarées, aucun benchmark exécuté.
- NIST, AI 600-1, juillet 2024, section sur les réponses erronées et les risques d’évaluation, consultée le 19 octobre 2026.