Tokens et fenêtre de contexte : pourquoi une IA ne lit pas comme nous
Édition : Célia
Tokens, caractères et contexte : une expérience reproductible sur sept textes explique le découpage, les limites et ce que les compteurs ne prouvent pas.
Un modèle de langue ne reçoit pas directement un texte sous la forme de mots bien séparés. Un logiciel, le tokeniseur, transforme ce texte en une suite de nombres. Chaque nombre désigne une unité appelée token : parfois un mot, parfois un morceau de mot, parfois de la ponctuation ou des octets. La fenêtre de contexte limite la quantité d’information que le système peut traiter dans une requête. Elle ne garantit ni que tous les passages seront utilisés correctement, ni que le modèle se souviendra du document lors d’une conversation future.
Cette distinction paraît abstraite jusqu’au moment où un fichier ne tient plus dans un outil, où une facture augmente ou où un assistant oublie une exception pourtant écrite dans le document. Pour comprendre ces situations, il faut séparer trois questions : comment le texte est découpé, quelle quantité entre dans le système et ce que le modèle en fait réellement.
Un token n’est pas une unité de sens universelle
Dans une phrase française, nous reconnaissons les mots, leurs accords et leurs relations. Le tokeniseur accomplit une opération différente : il convertit une chaîne de caractères suivant un vocabulaire et des règles. Il ne vérifie pas qu’un fragment obtenu correspond à une notion linguistique. Un même mot peut ainsi être représenté par plusieurs unités, tandis qu’un espace peut être attaché au fragment suivant.
La documentation de Hugging Face présente notamment BPE, WordPiece et Unigram, trois familles de méthodes fondées sur des sous-mots. Elles cherchent un compromis entre un vocabulaire immense contenant chaque mot possible et une suite très longue composée de caractères isolés. Des mots peu fréquents peuvent être représentés en assemblant des fragments connus. Cela n’implique pas que tous les systèmes découpent une phrase de la même manière. Présentation des algorithmes de tokenisation.
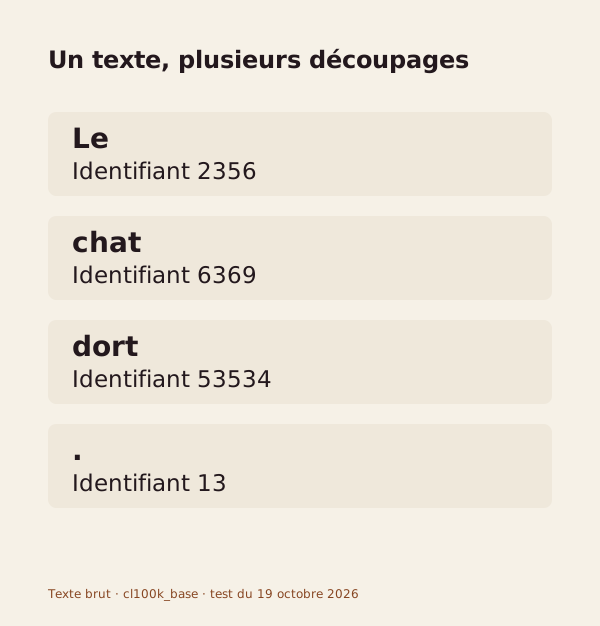
Le nombre associé à un token est un identifiant dans un vocabulaire donné. Il ne constitue pas une mesure de son importance. Dans notre calcul, le fragment « Le » porte l’identifiant 2356 avec un encodage, et 2486 avec l’autre. Ces nombres différents ne signifient pas que l’un comprend mieux l’article défini. Ils montrent simplement que les dictionnaires ne sont pas interchangeables.
Il faut aussi distinguer caractères et octets. La phrase « Électricité, mémoire et souveraineté. » contient 37 caractères au sens du comptage Python utilisé ici, mais occupe 41 octets en UTF-8. Les caractères accentués expliquent une partie de cet écart. Un compteur de caractères de traitement de texte ne remplace donc pas le compteur de tokens du système choisi.
Une expérience reproductible sur sept chaînes de texte
Pour rendre le découpage visible, nous avons exécuté un calcul local le 19 octobre 2026 avec tiktoken 0.14.0, sous Python 3.14.8. Deux encodages publics, cl100k_base et o200k_base, ont reçu exactement les mêmes chaînes. Aucun modèle de génération n’a été appelé. L’expérience mesure une conversion de texte, pas l’intelligence, la vitesse de réponse ou la qualité d’un assistant.
Le projet officiel tiktoken fournit l’encodeur, le décodeur et les vocabulaires correspondants. Le script conserve les identifiants de tokens et les octets de chaque fragment. Il vérifie également que le décodage de la séquence complète restitue le texte initial. Script de reproduction et résultats complets.
| Texte exact | cl100k_base |
o200k_base |
|---|---|---|
| Le chat dort. | 4 | 4 |
| Le chat dort dans le jardin. | 7 | 7 |
| Électricité, mémoire et souveraineté. | 13 | 9 |
| electricity, memory and sovereignty. | 7 | 7 |
| AB-7429-XQ | 6 | 6 |
| Bonjour ! | 2 | 2 |
| Bonjour! | 2 | 2 |
Comptages calculés sur le texte brut, sans ajout de message système, d’historique ou de format de conversation. Ces sept chaînes ne constituent pas un échantillon représentatif d’une langue.
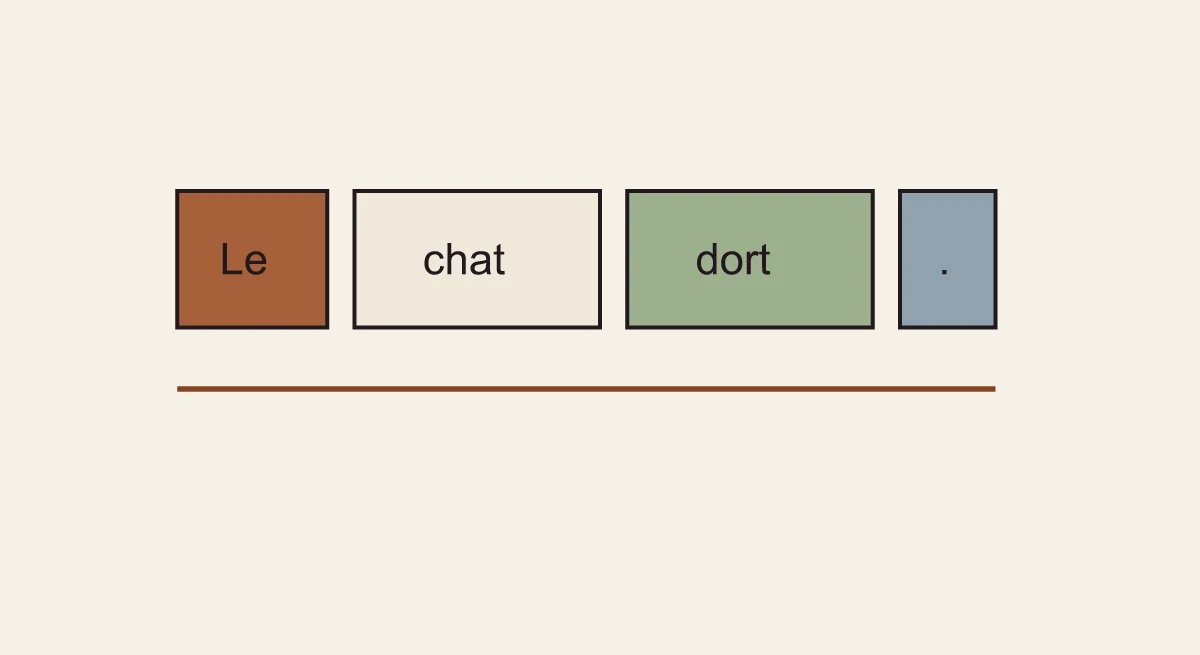
La phrase la plus courte est découpée en quatre éléments : « Le », « chat » précédé de son espace, « dort » précédé de son espace, puis le point. Il y a trois mots, mais quatre tokens. Notre référence fictive « AB-7429-XQ » devient six tokens alors qu’un lecteur la perçoit comme un seul identifiant. Cela explique pourquoi estimer une base de références produits à partir du seul nombre de mots peut être trompeur.
La phrase française plus technique offre une autre observation : son compte passe de treize à neuf tokens selon l’encodage. La chaîne anglaise choisie reste à sept dans les deux cas. On peut conclure que ces textes précis ne sont pas découpés pareil. On ne peut pas en déduire un surcoût constant du français, ni classer globalement les encodages sur leur efficacité multilingue. Il faudrait un corpus représentatif, une méthode d’échantillonnage et des résultats sur l’ensemble de ce corpus.
Les deux écritures de « Bonjour » apportent une nuance utile. Supprimer l’espace avant le point d’exclamation modifie les fragments et leurs identifiants, mais ne réduit pas ici leur nombre. Une transformation typographique peut donc changer le texte sans économiser de token. Réécrire systématiquement des documents pour enlever des espaces serait une mauvaise règle générale : le résultat doit être mesuré et la lisibilité préservée.
La fenêtre de contexte est une capacité de travail
La fenêtre de contexte désigne une limite du modèle ou du service qui l’expose. Pour savoir ce qu’elle couvre, il faut lire sa documentation exacte : instructions, documents, historique, sorties et traitements internes peuvent avoir des limites ou des règles de comptabilisation distinctes. Le nom commercial d’un modèle ne suffit pas à établir le contrat d’une API donnée.
Imaginons un système pédagogique dont la capacité totale est fixée, pour l’exemple, à 10 000 tokens. Si les instructions et l’historique en occupent 2 000, et si l’application réserve 1 000 tokens à la réponse dans cette capacité commune, il reste 7 000 tokens pour les documents. Ce calcul est une illustration arithmétique, pas la description d’un service réel. Il rend visible une règle de conception : le document n’est pas toujours le seul occupant de la fenêtre.
Lorsque cette capacité est dépassée, plusieurs comportements sont possibles selon le produit : refus de la requête, suppression de certains messages, découpage du document ou résumé préalable. Il faut vérifier lequel est appliqué. Une interface qui accepte un fichier ne prouve pas que toutes ses pages sont intégralement fournies au modèle lors de chaque question. Elle peut n’en transmettre que des passages sélectionnés.
Le terme « mémoire » entretient ici une confusion. Une longue conversation affichée à l’écran est un objet de l’application. Le contexte effectivement transmis est un autre objet. Un résumé conservé, une base documentaire consultée et les paramètres du modèle sont encore des mécanismes différents. Pour comprendre ce qui est disponible, demander où l’information est stockée, comment elle revient dans la requête et à quelle étape elle peut disparaître.
Tout faire entrer ne suffit pas à tout exploiter
Une fois le document dans le contexte, il reste une épreuve : retrouver l’élément pertinent et l’utiliser correctement. La capacité d’entrée et la qualité de restitution répondent donc à deux questions différentes. Un fichier accepté sans erreur technique peut donner lieu à une réponse qui manque une réserve ou combine deux passages incompatibles.
Une étude de Liu et ses coauteurs, publiée dans sa version consultée en novembre 2023 sous le titre Lost in the Middle, a déplacé l’information utile à différents endroits du contexte dans des tâches de questions documentaires et de recherche de paires clé-valeur. Les auteurs ont observé une sensibilité à cette position chez les modèles étudiés. Ce résultat historique justifie de tester la restitution ; il ne mesure pas les performances de tous les modèles disponibles aujourd’hui. Publication et protocole.
Une recette simple consiste à préparer un petit document dont on connaît les réponses, puis à poser des questions portant sur son début, son milieu et sa fin. Il faut inclure des exceptions, des dates et des cas où aucune réponse n’est fournie. Le résultat intéressant n’est pas seulement la fluidité de la réponse : c’est sa correspondance avec le passage attendu. Ce protocole proposé n’a pas été exécuté dans notre expérience de tokenisation ; il répond à une autre étape de l’évaluation.
Pour un dossier de plusieurs versions, ajouter davantage de pages peut même compliquer la question posée. Si une ancienne condition et sa correction restent toutes deux présentes sans date claire, l’entrée contient une ambiguïté réelle. La solution ne consiste pas nécessairement à acheter une plus grande fenêtre. Il peut être plus utile de nettoyer les versions, expliciter la chronologie ou limiter la recherche au bon périmètre.
Un compteur utile pour préparer un projet
Un compteur doit être relié au système réellement utilisé. Le choix de l’encodage, sa version et les transformations effectuées avant le comptage font partie du résultat. Un outil qui compte un texte extrait d’un PDF ne compte pas automatiquement les images, les en-têtes de conversation ou les informations ajoutées par l’application. Présenter son chiffre comme la facture finale serait aller au-delà de la mesure.
Pour un corpus professionnel, choisir des exemples qui reflètent son contenu : prose française, tableaux, références techniques, code, textes multilingues. Conserver les fichiers de test et le résultat détaillé permet de comprendre les écarts plutôt que de chercher une moyenne universelle. Les documents contenant des données privées n’ont pas à être envoyés à un site tiers pour cette première mesure : notre exemple utilise un outil local et des chaînes originales sans information sensible.
La taille du corpus complet et la taille d’une requête doivent également rester séparées. Une base documentaire peut contenir beaucoup plus de texte que la fenêtre du modèle si l’application en recherche seulement les passages utiles. Le compteur aide alors à fixer la place disponible pour ces passages ; il n’évalue pas leur pertinence. C’est un problème de recherche documentaire, abordé dans le dossier sur l’architecture RAG.
| Question à poser au fournisseur ou à l’équipe | Preuve utile | Ce que cela ne prouve pas |
|---|---|---|
| Quel encodage compte le texte ? | Nom, version et exemple reproductible | La qualité des réponses |
| Que contient la requête complète ? | Instructions, historique, passages et règles de sortie | Que tous les fichiers affichés sont transmis |
| Que se passe-t-il au dépassement ? | Comportement observé et documentation du service | L’absence de perte silencieuse dans toutes les situations |
| L’exception du document est-elle respectée ? | Questions de contrôle et passages attendus | Une fiabilité générale à partir d’un seul essai |
Ce qui compte avant de choisir
Le token est une unité de représentation, la fenêtre une capacité de traitement, et la réponse un résultat à vérifier. Confondre les trois conduit à demander au compteur une promesse qu’il ne peut pas donner. Notre calcul local établit des découpages précis et reproductibles ; il n’établit aucun classement de modèles.
Pour choisir un système, commencer par un échantillon réel et autorisé de documents, vérifier son comptage avec l’outil approprié, puis tester les réponses attendues. Garder les versions et les limites dans le dossier de décision. Cette démarche transforme une grande capacité annoncée en questions contrôlables : quelle entrée a été traitée, quelle information était disponible et quelle conclusion est effectivement soutenue ?
Sources et reproduction
- Hugging Face, Tokenization algorithms, documentation consultée le 19 octobre 2026.
- OpenAI, dépôt public tiktoken, version locale exécutée 0.14.0 le 19 octobre 2026.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, version arXiv du 20 novembre 2023, consultée le 19 octobre 2026.
- Calcul Pnebbula sur sept chaînes originales, deux encodages, sans appel à un modèle ; script et sorties liés dans le corps.