Sécuriser une base documentaire pour un assistant IA
Édition : Sophie
Faire suivre les droits d’accès de la source jusqu’aux fragments, à la réponse et aux caches d’un assistant documentaire.
Un assistant documentaire doit respecter les droits des documents qu’il utilise. La protection ne peut pas se limiter à l’écran de connexion ou à une consigne demandant au modèle de rester discret. Elle doit accompagner les fichiers, les passages indexés, les recherches, les caches et la réponse finale. Le point de départ est simple : une information ne doit pas entrer dans le contexte d’une réponse si son destinataire n’est pas autorisé à la recevoir. Mettre ce principe en pratique demande une identité fiable, des métadonnées à jour et des contrôles exécutés hors du modèle.
Le document change de forme, pas de sensibilité
Une chaîne RAG, ou génération augmentée par récupération, transforme souvent les documents en passages puis en représentations numériques utiles à la recherche. Ces transformations facilitent la sélection d’informations. Elles ne rendent pas automatiquement les contenus publics ou anonymes. Les métadonnées d’accès doivent rester reliées aux fragments, même lorsque ceux-ci sont stockés séparément du fichier d’origine.
La fiche OWASP sur la sécurité RAG insiste sur les droits associés aux fragments, l’isolation des espaces et la protection des caches. Elle rappelle aussi que les représentations numériques ne doivent pas être considérées comme des données anonymisées par défaut. Une architecture doit donc examiner toutes les copies et représentations utilisées, pas seulement le dossier où se trouve le document original.
Un exemple fictif permet de suivre le problème. Une entreprise conserve une procédure générale accessible à tous et une annexe réservée à une équipe. Si l’index mélange les passages sans conserver leurs permissions, une recherche peut retrouver l’annexe pour un utilisateur qui ne peut pas ouvrir le fichier source. Ajouter une citation vers ce fichier ne corrige pas la fuite : l’information a déjà pu être fournie au modèle.
Il faut donc traiter le passage comme un objet documentaire complet : contenu, source, version et droits. Une extraction qui conserve le texte mais perd les permissions n’est pas neutre. Elle modifie le périmètre de circulation de l’information. Le contrôle doit faire partie du contrat d’indexation et être vérifié lors de l’importation de nouvelles sources.
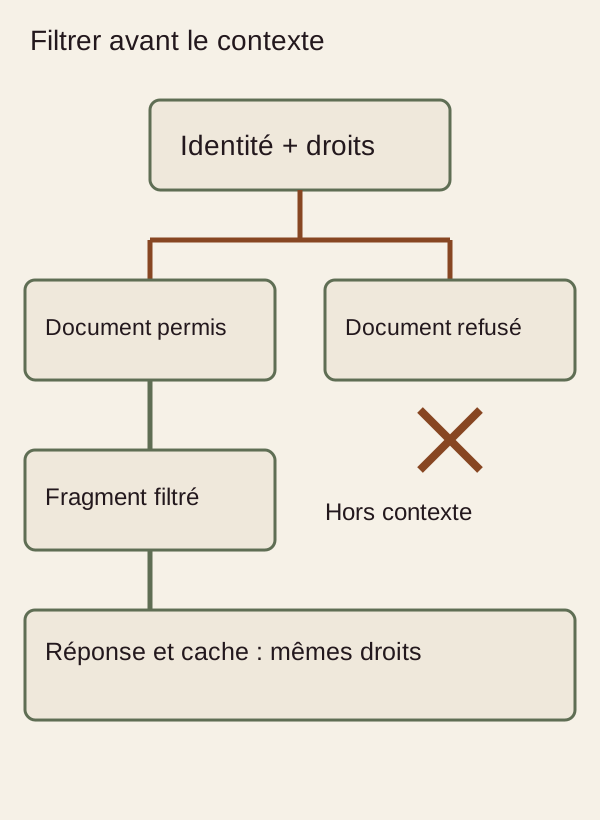
Filtrage des droits avant contexte, puis périmètre commun de réponse et cache.
Identifier qui pose la question et qui reçoit la réponse
L’identité utilisée par le moteur de recherche doit correspondre à l’utilisateur ou au contexte autorisé. Un compte de service disposant d’un accès très large peut être nécessaire pour certaines opérations d’administration, mais il ne doit pas transmettre automatiquement toute cette capacité aux lecteurs. La recherche doit appliquer les droits pertinents pour la demande, et non seulement ceux du connecteur technique.
Le destinataire compte également. Une personne peut être autorisée à lire un document sans être autorisée à en partager le contenu avec tous les participants d’une conversation. Si un assistant prépare une réponse collective, les règles de partage doivent être prises en compte. L’accès de celui qui déclenche la tâche ne résout pas à lui seul la question de l’accès de ceux qui recevront le résultat.
Ces contrôles relèvent de l’application et des services de données. Le modèle peut aider à formuler une réponse, mais ne doit pas devenir l’autorité qui décide qu’une personne possède un droit à partir d’une phrase dans le document. Une mention telle que « disponible pour toute l’équipe » peut être obsolète ou non autorisée. Les permissions doivent venir du système de référence défini par l’organisation.
La CNIL recommande de partir du besoin et des risques pour choisir un système d’IA générative. Dans une base documentaire, cette démarche implique de préciser quelles données sont nécessaires, pour quels utilisateurs et pour quelles actions. Le fait qu’un outil puisse techniquement indexer tous les fichiers n’établit pas que cette collecte soit justifiée.
Filtrer avant que le contenu soit fourni au modèle
Une architecture devrait empêcher les passages non autorisés d’entrer dans le contexte de génération. Attendre la réponse finale pour retirer les informations sensibles est une défense plus fragile : le modèle a déjà reçu les données et peut les reformuler. Le contrôle d’accès doit donc intervenir au niveau de la récupération, avec des règles explicites en cas d’information de permission absente ou incohérente.
Le moteur doit savoir comment appliquer ces règles à la recherche. Certains systèmes filtrent par utilisateur, groupe, espace ou classification. Ces mécanismes doivent être testés sur la configuration réellement utilisée. Une case « filtrage activé » ne prouve pas que chaque fragment possède les bonnes métadonnées ni que les combinaisons de droits sont correctes. Les cas négatifs, où une information doit rester inaccessible, sont essentiels.
Si le contrôle ne peut pas être effectué, le système doit adopter un comportement défini. Pour un corpus protégé, fournir quand même une réponse en contournant la récupération contrôlée peut annuler la protection. OWASP recommande des comportements de refus explicites en cas d’échec des contrôles. L’utilisateur doit comprendre qu’une information n’a pas été disponible dans le périmètre autorisé, sans recevoir des détails sensibles sur ce qui lui est caché.
Cette logique ne signifie pas que toute absence de résultat est une interdiction. Le document peut simplement ne pas exister, être mal indexé ou ne pas correspondre à la question. Les états doivent être distingués dans les journaux destinés aux opérateurs, avec une information adaptée pour l’utilisateur. Le diagnostic interne peut être précis sans révéler l’existence d’une ressource confidentielle à une personne non autorisée.
Construire une matrice rôle, document, action
Une matrice aide à rendre les attentes vérifiables. Elle ne doit pas inventer les permissions de l’organisation : elle les reprend depuis les règles approuvées. L’exemple ci-dessous est fictif et sert uniquement à montrer la structure d’un contrôle.
| Rôle fictif | Document fictif | Action | Attendu dans cet exemple |
|---|---|---|---|
| Lecteur général | Guide public interne | Consulter | Autorisé |
| Lecteur général | Annexe réservée | Rechercher le contenu | Refusé |
| Équipe habilitée | Annexe réservée | Consulter | Autorisé |
| Équipe habilitée | Annexe réservée | Partager à tous | À vérifier séparément |
| Compte retiré du groupe | Ancienne annexe accessible | Réutiliser un cache | Refusé après révocation |
Pour chaque ligne réelle, l’équipe prépare une requête, une réponse attendue et une preuve de résultat. Les tests doivent couvrir les citations, les extraits, les résumés et les caches. Une interface peut refuser l’ouverture du fichier tout en affichant un extrait trop détaillé dans les résultats. La matrice oblige à regarder chaque action plutôt qu’une seule permission générale de lecture.
Les mises à jour de droits doivent atteindre les copies
Les droits changent : départ d’une personne, changement d’équipe, retrait d’un partage ou reclassification d’un document. Une base indexée doit répercuter ces modifications. Si les permissions sont copiées une fois puis oubliées, elles deviennent une photographie ancienne du système de référence. La sécurité dépend alors du délai et de la fiabilité de leur mise à jour.
Il faut définir ce qui se passe entre le changement à la source et sa propagation. Certaines architectures interrogent les droits au moment de la requête ; d’autres synchronisent des métadonnées. Chaque choix possède des contraintes de disponibilité et de fraîcheur. L’important est de documenter cette fenêtre, de la réduire selon le risque et de tester la révocation, plutôt que de supposer qu’elle est instantanée.
Les caches demandent une attention spécifique. Une réponse précédemment autorisée peut rester stockée après un changement de droits. Le cache doit être isolé selon le périmètre pertinent et invalidé lorsque ses conditions ne sont plus valables. Un résultat réutilisé n’est pas exempté des permissions parce qu’il a déjà été calculé. La traçabilité doit permettre de relier une entrée de cache à ses sources et à ses conditions d’accès.
La suppression concerne aussi les dérivés. Retirer un fichier ne prouve pas que les fragments, les représentations numériques et les réponses conservées ont été retirés ou rendus inaccessibles. Il faut définir les règles de conservation et les preuves attendues pour chaque composant. Le dossier ne doit pas annoncer une suppression complète à partir d’un seul clic réussi dans l’interface source.
Journaliser sans créer une nouvelle fuite
Les journaux aident à comprendre quels documents ont contribué à une réponse et quels contrôles ont été appliqués. Ils peuvent cependant devenir une nouvelle collection de données sensibles. Leur contenu doit être minimisé, leurs accès contrôlés et leur conservation définie. Enregistrer systématiquement chaque passage confidentiel n’est pas la seule manière de disposer d’une preuve d’exécution.
On peut conserver des identifiants de version, des résultats de contrôle et des références aux objets, avec des accès séparés au contenu lorsque l’enquête le nécessite. Le choix exact dépend du système et des obligations applicables. Il faut éviter d’exposer des secrets dans des messages d’erreur ou dans des outils de suivi accessibles à un périmètre plus large que la base elle-même.
La revue doit aussi couvrir les connecteurs et les opérations d’administration. Qui peut ajouter une source, modifier les permissions importées ou lancer une réindexation ? Une séparation des responsabilités peut être nécessaire. Les contrôles sur les lecteurs seraient insuffisants si une opération d’ingestion pouvait silencieusement remplacer toutes les règles d’accès.
Vérifier avant d’élargir le corpus
Un premier essai peut employer un petit ensemble de documents fictifs avec des droits contrastés. Il vérifie la lecture autorisée, le refus, la révocation et la suppression. Aucun contenu sensible réel n’est nécessaire pour démontrer que les mécanismes attendus fonctionnent sur ces cas. Les résultats doivent ensuite être confrontés aux contraintes du système de production avant d’élargir l’usage.
Ce qui reste à démontrer pour une installation réelle est le fonctionnement de bout en bout : source, index, recherche, contexte, réponse et cache. Une consigne correcte ou une connexion authentifiée ne prouvent pas cette chaîne. La sécurité documentaire vient de contrôles appliqués à chaque transformation et vérifiés dans les cas difficiles. Cet article fournit une architecture de raisonnement, sans garantir une conformité générale ni certifier un produit particulier.
La recette doit conserver les résultats négatifs autant que les lectures réussies. Pour chaque rôle, demander un contenu autorisé puis un contenu interdit permet de vérifier que l’application distingue effectivement les deux situations. Après retrait d’un droit, reprendre la même requête et contrôler le cache évite de se fier uniquement à l’état affiché dans l’administration. Ces observations constituent des preuves locales limitées aux versions testées ; elles doivent être renouvelées après une modification importante de la chaîne.
Pour approfondir cette distinction, consulter le dossier Injection de prompt : quand un document devient une fausse instruction.
Pour vérifier la compréhension du dispositif sans exposer de vraies données, une équipe peut préparer deux documents factices dont les droits diffèrent. Le protocole doit préciser les identités de test, les réponses attendues et le moment de la modification des droits. Nous décrivons ici une préparation possible ; aucun contrôle de ce type n’a été exécuté sur une installation réelle pour cet article.
Sources
- OWASP, « RAG Security Cheat Sheet », sections droits, isolation, caches et refus en cas d’échec, consultées le 19 octobre 2026.
- CNIL, questions-réponses sur l’utilisation des systèmes d’IA générative, 18 juillet 2024, consultées le 19 octobre 2026.