IA médicale : pourquoi une bonne précision ne démontre pas un bénéfice pour le patient
Édition : Sophie
Distinguer précision d’une IA médicale, validation clinique et bénéfice pour le patient : populations, erreurs et conditions d’évaluation.
Un système d’intelligence artificielle peut bien classer des images ou repérer des anomalies sans que son utilisation améliore automatiquement la santé des patients. Entre le score du modèle et le résultat clinique interviennent la qualité des données, les erreurs, la décision du professionnel et l’organisation des soins. L’évaluation doit donc porter sur une tâche précise, une population et un usage. Pour lire une annonce, il faut demander non seulement ce que le logiciel reconnaît, mais ce que son résultat change réellement dans le parcours de soin, avec quels bénéfices et quels effets indésirables.
La première question est celle de l’usage
L’expression « IA médicale » rassemble des fonctions très différentes. Un outil peut mesurer une structure sur une image, signaler un examen à relire en priorité ou estimer un risque. Ces tâches n’exigent pas les mêmes critères d’évaluation. Une mesure correcte ne garantit pas une bonne décision, et une décision correcte ne garantit pas que le parcours permette d’agir à temps.
La FDA consacre un programme de recherche au choix des métriques et à l’incertitude. Elle distingue notamment classification, estimation, segmentation et détection. Elle souligne aussi que la présentation du résultat et la structure des données influencent le choix des mesures pertinentes. Il serait donc trompeur de classer tous les outils avec un seul chiffre.
L’usage prévu doit préciser qui reçoit la sortie et ce qu’il est censé en faire. Une alerte destinée à aider un professionnel n’a pas la même place qu’une décision automatisée. La fréquence d’utilisation, les informations disponibles et les possibilités de vérifier le résultat comptent. Sans cette description, même un excellent score reste difficile à interpréter pour le lecteur.
Une formulation utile serait : « le logiciel aide tel utilisateur à réaliser telle tâche, chez telle population, dans telles conditions ». Elle oblige à délimiter la promesse. Si une annonce parle ensuite d’un bénéfice plus large, il faut rechercher la preuve supplémentaire qui relie la tâche technique au résultat clinique revendiqué.
Ce que mesure un score, et ce qu’il laisse de côté
La sensibilité décrit la capacité à repérer les cas positifs selon la référence utilisée ; la spécificité concerne les cas négatifs. D’autres mesures résument le classement ou la correspondance entre probabilités annoncées et observations. Elles répondent à des questions différentes. Le mot « précision », employé sans définition, peut ainsi masquer des indicateurs qui ne sont pas directement comparables.
Le guide de l’Organisation mondiale de la santé sur la production de preuves pour les logiciels médicaux fondés sur l’IA distingue discrimination et calibration. Un modèle peut bien ordonner les situations du moins au plus risqué tout en fournissant des probabilités mal ajustées. Cette différence importe lorsque les utilisateurs interprètent le nombre affiché comme une estimation utilisable.
Les seuils changent également la répartition des erreurs. Déclencher davantage d’alertes peut repérer plus de situations à examiner, mais augmente aussi le travail de vérification. Le seuil pertinent dépend de la tâche et des conséquences des erreurs. Il ne peut pas être choisi uniquement pour rendre un indicateur favorable dans une présentation commerciale.
Il faut enfin demander comment la vérité de référence a été établie. La FDA rappelle que les étiquettes peuvent comporter une variabilité ou une incertitude, notamment lorsqu’elles reposent sur une appréciation d’experts. Le modèle n’est pas comparé à une vérité parfaite par simple présence d’un jeu de données. La qualité de la référence fait partie de l’évaluation.
Une base d’images ne représente pas tout un parcours de soin
Une étude rétrospective peut utiliser des données déjà collectées pour examiner le fonctionnement d’un modèle. Elle est utile, mais elle ne reproduit pas nécessairement les conditions d’arrivée des patients, les informations manquantes et les décisions prises en temps réel. La question de généralisation porte donc sur la population et sur l’organisation qui produisent les données.
Le guide de l’OMS recommande d’examiner les sous-groupes pertinents et les différences liées aux sites ou au matériel. Une moyenne peut masquer un fonctionnement moins satisfaisant dans une partie des situations. Cela ne justifie pas de multiplier arbitrairement des analyses jusqu’à trouver un résultat : les groupes et la méthode doivent être pertinents pour l’usage et interprétés avec leurs limites.
Un changement de dispositif d’imagerie, de protocole d’acquisition ou de population peut modifier la nature des entrées. La validation externe cherche à éprouver cette portabilité dans d’autres conditions. Elle est différente d’une nouvelle mesure sur des données très proches de celles utilisées pendant le développement. Le lecteur doit chercher d’où proviennent les données de test et comment elles ont été séparées.
L’absence d’une donnée possède aussi une signification pratique. Si le logiciel exige une information rarement disponible au moment de la décision, sa performance idéale peut être peu représentative de son utilité. L’évaluation doit décrire les cas exclus ou non traitables, plutôt que mesurer uniquement les cas où toutes les conditions sont réunies.
L’erreur technique devient un événement dans le parcours
Une fausse alerte peut entraîner une vérification supplémentaire ; une anomalie manquée peut retarder une action. L’importance clinique dépend du contexte, des autres contrôles et des possibilités de rattrapage. On ne peut pas transformer mécaniquement chaque erreur informatique en dommage, mais on ne peut pas non plus l’effacer en invoquant la présence d’un professionnel.
Le professionnel et l’outil constituent ensemble un système d’usage. L’interface peut aider à comprendre une sortie ou rendre une limite difficile à voir. La formation peut modifier la manière dont une alerte est interprétée. Le guide de l’OMS relie explicitement l’impact clinique à l’intégration dans les pratiques, aux instructions, à l’expérience utilisateur et aux études réalisées dans des conditions réelles.
Une comparaison avec un humain doit donc être équitable. Les professionnels comparés doivent disposer d’un temps et d’informations cohérents avec leur rôle. Présenter un modèle isolé face à un lecteur privé du contexte habituel ne répond pas nécessairement à la question du service clinique. Pour une aide à la décision, comparer la pratique avec et sans l’outil peut être plus directement pertinent.
Ce qui compte : le bénéfice dépend de la chaîne complète. Repérer une situation plus tôt n’a pas la même valeur si aucune action utile ne suit, si la confirmation surcharge le service ou si le résultat change une décision déjà correcte. Ces possibilités sont des questions à mesurer, pas des conclusions présumées contre la technologie.
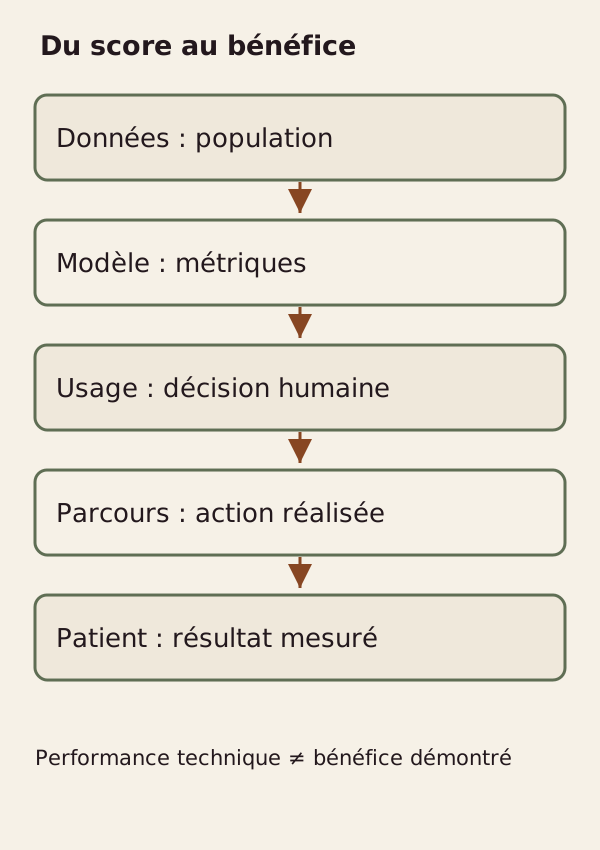
Le schéma distingue les étapes où une preuve est nécessaire. Il n’attribue aucun résultat clinique à un produit particulier.
Comment démontrer une utilité clinique
L’OMS explique qu’un algorithme performant suffit rarement, à lui seul, à démontrer un impact clinique. Une étude adaptée doit définir les résultats attendus, le comparateur, les participants et le suivi. Selon la question, elle peut examiner des résultats pour les patients, des changements dans les processus ou du temps économisé. Ces catégories ne doivent pas être présentées comme équivalentes.
Un gain de temps documenté peut être utile à un établissement sans prouver une amélioration de la santé. Inversement, une amélioration clinique peut demander une organisation plus complexe. L’analyse doit rapporter les deux dimensions lorsqu’elles sont pertinentes. Le lecteur ne doit pas avoir à deviner si « efficacité » désigne un résultat technique, organisationnel ou médical.
Une étude prospective permet d’observer l’outil pendant que le parcours se déroule. La présence d’un comparateur et la manière d’attribuer les conditions d’étude influencent la portée des conclusions. L’OMS discute notamment la randomisation lorsque plusieurs groupes sont étudiés, la durée du suivi et la déclaration des conséquences non souhaitées. Il ne suffit donc pas d’ajouter l’étiquette « en conditions réelles ».
Les personnes perdues de vue et les données manquantes doivent aussi être examinées. Si certains résultats ne sont connus que pour une partie des participants, l’analyse peut refléter cette sélection. Une évaluation convaincante décrit ces absences et leurs conséquences possibles. Une grande taille de base ne dispense pas de comprendre qui est réellement suivi.
Grille d’évaluation d’une annonce
| Dimension | Preuve à demander | Limite à conserver |
|---|---|---|
| Tâche | Usage prévu et sortie exacte | Le score ne couvre pas toutes les fonctions |
| Référence | Méthode d’annotation ou de confirmation | La référence peut être incertaine |
| Population | Origine et diversité des données | Une moyenne masque parfois des écarts |
| Usage | Étude avec utilisateurs et contexte | Le modèle seul ne décrit pas le service |
| Bénéfice | Résultat clinique ou organisationnel défini | Temps gagné et santé améliorée diffèrent |
| Suivi | Version, surveillance et incidents | La preuve ne reste pas actuelle sans contrôle |
Cette grille est une synthèse éditoriale des principes exposés par la FDA et l’OMS. Elle n’évalue aucun dispositif nommé. Son utilisation consiste à relier chaque promesse à une preuve du même niveau, puis à noter ce qui manque, plutôt qu’à attribuer une note globale séduisante mais peu interprétable.
Le suivi commence aussi après le déploiement
Le logiciel peut être mis à jour, les appareils peuvent changer et les pratiques peuvent évoluer. Le guide de l’OMS insiste sur la gestion des versions et la surveillance après déploiement. Une publication ancienne sur une version ne prouve pas automatiquement le comportement d’une version ultérieure. La traçabilité relie le résultat observé à l’objet réellement utilisé.
Le suivi doit pouvoir repérer des dérives et des conséquences inattendues. Cela comprend la performance technique, mais aussi les effets en aval et les difficultés rapportées par les utilisateurs. Une absence de signal n’est informative que si le dispositif de surveillance permet de détecter les problèmes pertinents. La qualité du suivi fait donc partie de la confiance accordée au système.
Pour un établissement, l’évaluation gagne à partir d’un problème concret : une étape du parcours à améliorer et un résultat mesurable. Le choix d’un outil vient ensuite, avec les conditions nécessaires à son intégration et à sa vérification. Cette démarche évite de transformer une démonstration technique en promesse clinique avant d’avoir étudié son utilité réelle.
Ce qui reste à démontrer : pour chaque dispositif, la portée des résultats dépend de la tâche, des utilisateurs, de la population et de la version. Un score élevé peut constituer une étape importante. La conclusion sur le bénéfice pour les patients demande les preuves supplémentaires qui relient cette étape au parcours complet.
Le mot « humain » ne définit pas un comparateur
Une annonce peut affirmer que le logiciel égale ou dépasse des professionnels. Pour interpréter cette comparaison, il faut savoir qui a participé, avec quelle expérience et dans quelles conditions. L’OMS demande notamment que le temps et les informations fournis aux lecteurs soient pertinents pour l’usage réel. Un exercice isolé ne représente pas automatiquement le travail d’une équipe dans un parcours complet.
Il faut ensuite distinguer le professionnel seul et le professionnel assisté. Un outil destiné à aider les soignants doit être évalué en tenant compte de cette interaction. Le classement du modèle isolé ne démontre pas que son ajout améliorera la décision. La question pertinente reste celle de l’usage pour lequel le dispositif a été conçu.
Sources et périmètre
Sources lues le 19 octobre 2026 : FDA, programme de recherche sur les métriques et l’incertitude ; OMS, Generating evidence for artificial intelligence-based medical devices: a framework for training, validation and evaluation, 2021, notamment chapitres 13 et 14. Le guide est utilisé pour ses principes méthodologiques ; il ne suffit pas à établir l’ensemble des exigences réglementaires applicables en 2026. Ce dossier ne classe aucun produit et ne fournit ni diagnostic individuel ni certification réglementaire.