Empoisonnement des données : la sécurité de l’IA commence avant le modèle
Édition : Sophie
Suivre la provenance des données, détecter les modifications et enquêter sur un document altéré dans une chaîne IA.
Empoisonner les données consiste à introduire ou modifier intentionnellement des contenus de manière malveillante pour influencer le comportement d’un système. L’attaque peut viser les données d’apprentissage ou les documents consultés au moment de répondre. La défense commence donc avant la génération : identifier les sources, contrôler les modifications et conserver une chaîne de provenance. Une réponse assortie d’une citation n’est pas nécessairement fiable si le document cité a été altéré. Pour comprendre un incident, il faut retrouver ce que le système a réellement lu, dans quelle version et par quel chemin ce contenu est entré.
Une information fausse peut être très bien présentée
Un document peut reprendre la forme d’une procédure officielle et contenir une règle incorrecte. Si un assistant le récupère, sa réponse peut sembler cohérente et sourcée tout en reproduisant cette erreur. L’empoisonnement ne nécessite donc pas toujours une phrase ordonnant explicitement au modèle de désobéir. Il peut agir sur les faits disponibles, leur classement ou la manière dont une collection documentaire représente un sujet.
Il faut distinguer cette situation d’une simple erreur de contenu. Une procédure obsolète, une mauvaise saisie ou une migration défectueuse peuvent produire des effets comparables sans intention malveillante. L’enquête ne doit pas conclure à une attaque à partir d’une seule réponse anormale. Le terme décrit une manipulation intentionnelle ; la méthode de contrôle de provenance reste néanmoins utile pour diagnostiquer des erreurs ordinaires.
La fiche OWASP sur la sécurité des chaînes RAG traite notamment l’introduction de documents malveillants dans un corpus de recherche. RAG signifie génération augmentée par récupération : le système recherche des passages puis les fournit au modèle. Cette architecture ne change pas automatiquement les poids du modèle. Elle peut cependant modifier ses réponses en changeant les informations qu’il reçoit.
L’empoisonnement de l’apprentissage agit à un autre moment. Les données modifiées participent à l’ajustement des paramètres. Retirer ensuite un document de la base de recherche ne suffit pas à défaire un apprentissage antérieur. La distinction entre corpus d’entraînement et corpus consulté est donc nécessaire pour choisir une mesure corrective. Il faut savoir quel composant a été exposé avant de promettre une remise en état.
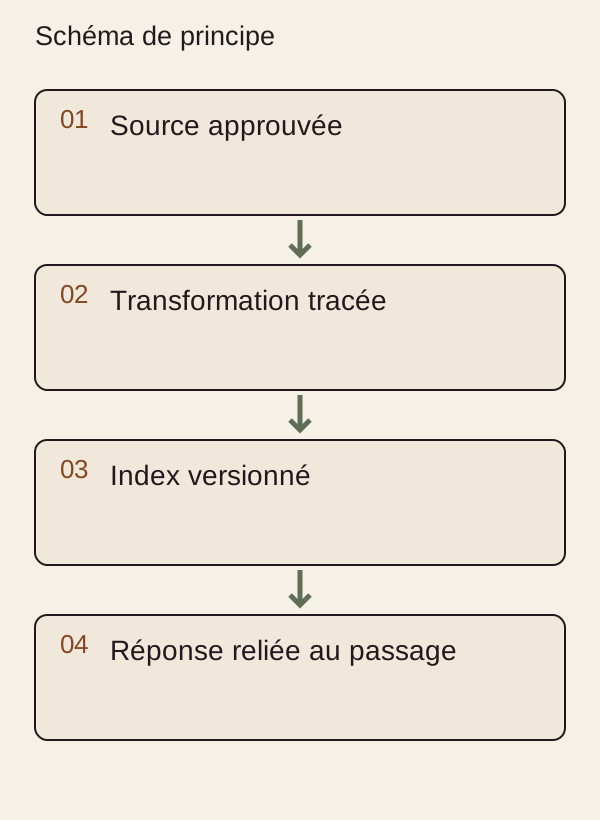
Schéma de principe original. Lecture : Source approuvée → Transformation tracée → Index versionné → Réponse reliée au passage. Aucun résultat mesuré.
La provenance accompagne les transformations
Un document traverse souvent plusieurs étapes : collecte, conversion, découpage, indexation et récupération. À chaque transformation, il peut perdre des éléments utiles à son interprétation. Une note de bas de page peut être séparée de son tableau ; une date peut disparaître du passage ; une correction peut ne pas être propagée à l’index. La provenance ne se réduit pas à une adresse web enregistrée une fois.
Chaque passage devrait pouvoir être relié à un document source, à une version et à une opération de traitement. Cela permet de distinguer l’auteur du document de la personne qui l’a importé. Cela permet aussi d’examiner si une erreur existait dans la source ou est apparue lors de l’extraction. Sans cette distinction, le modèle risque de recevoir une information dont personne ne sait expliquer le parcours.
Une liste de sources approuvées limite la surface d’entrée, mais ne garantit pas que tout contenu provenant de ces sources soit correct. Des permissions de contribution, des commentaires ou des systèmes connectés peuvent introduire des modifications. Il faut préciser qui peut ajouter une source, qui peut approuver un document et qui peut modifier la référence de confiance. Ces fonctions peuvent demander des responsabilités séparées selon les risques.
Le profil NIST AI 600-1 aborde la provenance des contenus et les risques liés aux composants de la chaîne de valeur. Ce document propose une gestion des risques sur le cycle de vie ; il ne certifie pas une base de données particulière. Il aide à replacer l’intégrité documentaire dans une organisation, avec des responsables et des procédures de traitement des incidents.
Une empreinte prouve une identité, pas une vérité
Une empreinte cryptographique permet de comparer un fichier à une référence. Si le contenu change, son empreinte change normalement aussi. Ce mécanisme est utile pour détecter un écart à un document approuvé. Mais il ne détermine pas si le document approuvé est exact, sûr ou pertinent. Une fausse information peut posséder une empreinte parfaitement stable.
OWASP insiste aussi sur la protection de la référence elle-même. Si la même personne peut remplacer le document et l’empreinte censée le vérifier, le contrôle perd sa valeur. La référence doit être conservée et validée dans un périmètre distinct, avec un processus explicite de mise à jour. L’intégrité est une relation entre un objet et une référence digne de confiance, pas un attribut magique ajouté par une fonction de calcul.
Il faut donc associer contrôle de contenu et contrôle de modification. Le premier examine ce qui est affirmé et qui l’autorise. Le second vérifie que le document utilisé correspond à la version approuvée. Une nouvelle version légitime doit pouvoir entrer sans être traitée comme une attaque, mais son approbation doit laisser une trace. Cette organisation évite de bloquer les mises à jour tout en refusant les substitutions silencieuses.
Suivre un exemple de document modifié
Prenons un scénario fictif de maintenance industrielle, sans consigne technique réelle. Une base contient une fiche indiquant quel service contacter en cas d’anomalie. Une modification non approuvée remplace le service par une autre destination. Le modèle peut reprendre cette destination sans enfreindre sa consigne de synthèse : il utilise simplement une source altérée. C’est la chaîne documentaire qui doit permettre de détecter le problème.
L’enquête commence par le passage réellement récupéré. On le compare au document approuvé et à son historique. Puis on examine le moment d’importation, le compte ayant effectué la modification et les copies déjà indexées. Il faut également vérifier si la réponse a été conservée dans un cache ou reprise dans un autre document. Corriger le fichier visible ne garantit pas que toutes ses représentations dérivées ont disparu.
Ce scénario montre la différence avec l’injection de prompt. Une injection tente de transformer le contenu en instruction. Ici, la mauvaise destination peut être présentée comme un fait ordinaire. Les deux mécanismes peuvent se combiner, mais leur diagnostic ne doit pas être confondu. Filtrer quelques expressions impératives ne détecterait pas nécessairement une altération factuelle crédible.
| Étape | Preuve à conserver | Question après incident |
|---|---|---|
| Collecte | Origine et autorisation | La source était-elle admise ? |
| Validation | Version approuvée | Qui a accepté le contenu ? |
| Conversion | Entrée et sortie associées | Le sens a-t-il été modifié ? |
| Indexation | Version des passages | L’index contient-il l’ancienne fiche ? |
| Réponse | Passages utilisés | La réponse suit-elle cette source ? |
| Correction | Copies invalidées | Le contenu retiré reste-t-il accessible ? |
La grille est une proposition d’enquête documentaire. Elle n’implique ni qu’un incident a eu lieu ni qu’un outil particulier enregistre déjà tous ces éléments.
La recherche peut amplifier un document problématique
Le moteur de récupération classe des passages selon une méthode de pertinence. Un document faux mais proche des termes recherchés peut être sélectionné. Le fait qu’il apparaisse parmi les premiers résultats ne constitue pas une validation de son autorité. Les métadonnées de provenance, de date et de statut doivent rester disponibles pour aider le système et l’utilisateur à interpréter ce qu’ils lisent.
Multiplier les documents ne suffit pas à créer une corroboration. Plusieurs pages peuvent recopier la même erreur ou provenir d’une même source initiale. Une vérification utile cherche des provenances distinctes et examine les désaccords. Dans une base interne, cela peut signifier comparer une procédure avec le registre qui l’autorise, plutôt qu’avec une présentation qui la résume. La relation entre les sources compte autant que leur nombre.
Il faut aussi éviter de confondre popularité et fiabilité. Un document souvent consulté peut être ancien ; une correction récente peut être moins bien retrouvée. Le protocole de mise à jour doit définir comment une version remplace une autre et comment les passages contradictoires sont signalés. La date de collecte ne remplace pas la date d’effet d’une règle ou la période d’une mesure.
Prévenir sans transformer la base en système immobile
Les contrôles doivent rester proportionnés au contenu. Une base de brouillons publics et une base utilisée pour des décisions sensibles ne demandent pas le même processus d’approbation. L’important est de rendre ce choix explicite. Les droits de contribution, les validations et les délais de mise à jour doivent correspondre aux conséquences d’une information incorrecte.
Une revue régulière peut examiner un échantillon de documents, les changements récents et les erreurs signalées. Elle doit inclure les transformations automatiques : changer un parseur ou un modèle d’indexation peut modifier les passages sans modification apparente du fichier original. Le journal des versions techniques aide à retrouver ces événements. Une alerte d’intégrité doit déclencher un diagnostic, pas être noyée dans un simple indicateur de disponibilité.
En cas de doute important, le système peut suspendre l’usage du document concerné, signaler la limite et éviter une réponse appuyée sur une référence incertaine. La reprise exige de valider la source corrigée et ses dérivés. Il faut conserver la preuve de la correction sans exposer inutilement les données de l’incident. Aucune mesure décrite ici ne constitue une garantie absolue contre l’empoisonnement.
Ce qui reste à démontrer pour une base réelle
Une architecture dessinée ne prouve pas que les contrôles fonctionnent. Il faut vérifier, dans un environnement autorisé, qu’une modification non approuvée est détectée, qu’une version retirée n’est plus utilisée et qu’une erreur d’extraction peut être expliquée. Les essais peuvent employer des documents fictifs portant des différences facilement identifiables. Aucun scénario de manipulation opérationnelle ni résultat d’attaque n’est fourni dans ce dossier.
Le critère final est la capacité à répondre à une question simple : pourquoi ce passage précis a-t-il été considéré comme utilisable à cet instant ? La réponse doit réunir source, version, autorisation et transformation. Une citation seule ne suffit pas. Cette discipline rend la base plus résistante aux manipulations, mais aussi plus facile à maintenir lorsque l’erreur vient d’un processus ordinaire plutôt que d’un adversaire.
Un exercice de maintenance peut partir d’un document factice dont on modifie uniquement la date d’effet. L’équipe vérifie ensuite les versions présentes dans l’index, les citations produites et les copies conservées. Il ne s’agit pas de démontrer une attaque, mais de rendre visible un chemin de mise à jour. Ce type de vérification simple permet de découvrir des ruptures de provenance avant qu’une information réellement importante ne dépende de la même chaîne.
Pour approfondir cette distinction, consulter le dossier Sécuriser une base documentaire pour un assistant IA.
Sources
- OWASP, « RAG Security Cheat Sheet », sections Document Poisoning, attribution et observabilité, consultées le 19 octobre 2026.
- NIST, « Generative Artificial Intelligence Profile », AI 600-1, juillet 2024, introduction et risques de chaîne de valeur, consultés le 19 octobre 2026.