Distillation : comment un petit modèle apprend d’un plus grand
Édition : Sophie
Comprendre le transfert professeur-élève, contrôler les exemples et vérifier les capacités conservées par un modèle distillé.
La distillation consiste à entraîner un modèle à partir des sorties ou du comportement d’un autre modèle. L’objectif peut être de disposer d’un système plus facile à déployer pour une tâche définie. Elle ne consiste pas à transférer intégralement une intelligence dans un fichier plus petit. Ce qui est transmis dépend des exemples, du signal d’apprentissage et des capacités du modèle qui apprend. Pour juger une annonce de distillation, il faut donc demander quelles tâches ont été conservées, lesquelles ont été évaluées séparément et ce que l’on sait des erreurs transmises avec les réponses.
Un professeur, un élève, mais aucune salle de classe
Les termes « professeur » et « élève » sont des métaphores usuelles. Le professeur est le système qui produit les indications servant à l’apprentissage. L’élève est celui dont les paramètres sont ajustés pour reproduire certains aspects de ces indications. Il n’existe pas de compréhension partagée explicite entre les deux. Un programme construit des exemples, calcule un écart et ajuste des paramètres selon une fonction d’apprentissage.
Le travail de Hinton, Vinyals et Dean a popularisé une manière de transférer le comportement d’un ensemble de modèles vers un modèle plus simple à déployer. Leur problème de départ distingue les conditions d’apprentissage de celles d’utilisation : un système encombrant peut être utile pour apprendre, alors que servir de nombreuses requêtes impose d’autres contraintes. Cette motivation reste compréhensible sans attribuer un gain universel à la méthode.
Une partie essentielle de l’idée est que la sortie du professeur peut contenir davantage d’information qu’une seule réponse correcte. Dans une classification, les préférences relatives entre plusieurs catégories donnent des indications sur les ressemblances que le modèle a apprises. Dans une génération de texte, on peut utiliser les réponses produites comme exemples à imiter. Ces procédés n’utilisent pas exactement le même signal et ne donnent pas accès aux mêmes informations.
Le professeur n’est d’ailleurs pas obligatoirement un unique modèle gigantesque. Selon le procédé, il peut s’agir d’un ensemble ou d’un système spécialisé. Ce qui définit la distillation est la relation d’apprentissage à partir de son comportement, pas un rapport de tailles obligatoire. Dans les applications où l’on vise un petit modèle, la réduction des contraintes de déploiement doit encore être mesurée sur la configuration choisie.
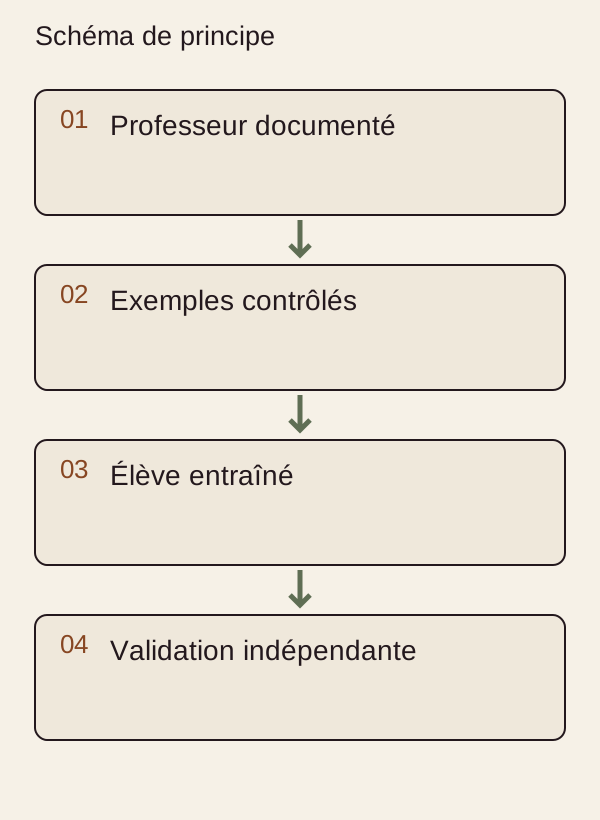
Schéma de principe original. Lecture : Professeur documenté → Exemples contrôlés → Élève entraîné → Validation indépendante. Aucun résultat mesuré.
Ce qui passe réellement d’un système à l’autre
Imaginons, à titre illustratif, une tâche de classement de questions techniques. Une annotation humaine peut donner une catégorie attendue. Le professeur peut fournir une catégorie, une justification ou des préférences entre catégories. L’élève n’apprend pas les mêmes choses selon ce qui lui est présenté. Une réponse seule lui donne un objectif de sortie ; une information plus riche peut éclairer des relations, mais elle peut aussi transporter des erreurs supplémentaires.
Il faut donc décrire le signal de transfert avant de parler de « connaissance conservée ». Le système copie-t-il des textes ? Cherche-t-il à rapprocher des distributions de sortie ? Utilise-t-il des représentations intermédiaires ? L’article ne prétend pas que toutes ces variantes sont disponibles dans un outil donné. Leur différence conceptuelle explique pourquoi deux projets de distillation ne se comparent pas uniquement avec le nombre de paramètres de leurs élèves.
Le modèle qui apprend conserve sa propre architecture et ses contraintes. Il peut reproduire des réponses familières tout en échouant lorsque la question change de forme ou exige plusieurs étapes. Un comportement observé sur un exemple n’établit pas la capacité générale qui semblait le produire chez le professeur. C’est particulièrement important lorsque les réponses contiennent une explication convaincante : imiter une explication et réussir systématiquement le problème ne sont pas la même mesure.
La distillation diffère ainsi de la quantification. Cette dernière change la représentation numérique de certains éléments d’un modèle. La distillation organise un nouvel apprentissage à partir d’un système enseignant. On peut envisager de combiner des transformations, mais chaque étape ajoute un objet à évaluer. Un fichier petit peut être quantifié, distillé, ou les deux ; son poids sur disque ne permet pas de le déduire.
Choisir les exemples revient à choisir le terrain
La distribution des exemples détermine ce que l’élève rencontre. Si les questions concernent surtout les cas habituels, il peut apprendre un comportement satisfaisant sur ces cas tout en restant fragile sur les exceptions. Une bibliothèque très volumineuse mais peu variée ne résout pas automatiquement cette faiblesse. Il faut examiner les catégories, les formulations, les informations manquantes et les situations où le professeur lui-même hésite ou se trompe.
Les réponses du professeur doivent être traitées comme des données à contrôler. Leur fluidité ne les rend pas vraies. Un fait incorrect répété sous plusieurs formulations peut devenir une cible d’apprentissage très cohérente. Filtrer les erreurs demande une référence extérieure lorsque le problème porte sur des faits. Pour une règle métier, il faut une règle approuvée ; pour un calcul, une vérification ; pour une information documentaire, un passage source pertinent.
Les données synthétiques peuvent servir à explorer des variantes, mais elles ne remplacent pas par définition les observations du terrain. Les formulations générées peuvent refléter les habitudes du modèle générateur. Les cas rares ou inconfortables peuvent manquer. Il faut garder une trace du mode de production, des consignes, des filtres et des exclusions. Cela permet de discuter ce qui a été couvert plutôt que d’afficher seulement un total d’exemples.
Cette préparation est aussi une question de droits. L’accès technique aux sorties d’un service ne démontre pas que ses conditions permettent tous les usages d’entraînement. Les licences des modèles, les termes du service et les droits portant sur les données doivent être lus pour le projet considéré. Aucun conseil juridique personnalisé n’est fourni ici ; la grille sert à identifier les documents nécessaires avant une décision.
Construire un dossier de transfert
La contribution pratique proposée est une carte qui relie chaque usage aux preuves attendues. Elle organise une revue de projet ; elle ne présente pas de résultats expérimentaux. Une ligne sans preuve reste ouverte même si le modèle produit déjà des démonstrations impressionnantes.
| Élément à transférer | Trace de fabrication | Vérification indépendante |
|---|---|---|
| Format de réponse | Exemples et règles de format | Validation automatique du format |
| Catégorisation | Définition des catégories | Cas annotés séparément |
| Information factuelle | Sources des réponses enseignantes | Passage documentaire vérifié |
| Gestion des exceptions | Cas ambigus et réponses attendues | Questions nouvelles et incomplètes |
| Limites d’usage | Instructions de refus et périmètre | Revue des erreurs graves |
La carte oblige à distinguer ce que le professeur apporte de ce que l’on vérifie ailleurs. Si toutes les réponses de référence et toutes les évaluations viennent du même professeur, le système est surtout jugé sur sa capacité à lui ressembler. Cette ressemblance peut être l’objectif d’une expérience, mais elle ne devient pas une preuve indépendante de justesse.
Un journal de production complète la carte : identité du professeur, version disponible, dates de génération, paramètres utiles et modifications apportées aux sorties. Il ne faut pas y conserver inutilement des données sensibles. L’objectif est de pouvoir expliquer un résultat ou reconstruire un sous-ensemble problématique, pas d’accumuler sans limite chaque échange et chaque identifiant.
Mesurer ce que le petit modèle sait encore faire
L’évaluation doit comporter des tâches que l’apprentissage n’a pas vues. La séparation concerne les situations, pas seulement les lignes de fichiers. Plusieurs variantes d’une même question peuvent partager la réponse et faciliter artificiellement le test. Il faut donc examiner les familles d’exemples et documenter la méthode de séparation. La documentation d’entraînement de Transformers fournit un cadre logiciel d’apprentissage et d’évaluation, mais le sens du test reste à définir pour chaque application.
Comparer l’élève au professeur est utile, à condition de conserver une référence extérieure pour les propriétés importantes. L’élève peut reproduire une erreur du professeur ou, dans certains cas, ne pas la reproduire. Le bon résultat n’est donc pas toujours celui qui ressemble le plus. Pour une extraction, on contrôle les valeurs ; pour une classification, les catégories ; pour une rédaction factuelle, les sources et les omissions significatives.
Il faut aussi comparer à une solution simple. Un petit modèle non distillé, une règle déterministe ou une recherche structurée peut déjà répondre au besoin. Cela ne dévalorise pas la distillation : cela empêche d’attribuer au procédé une utilité que l’expérience n’a pas isolée. Les conditions de calcul, de mémoire et de latence doivent être conservées dans le dossier si elles motivent le projet.
Les résultats se présentent par tâche et par catégorie d’erreur. Affirmer qu’un modèle conserve un certain pourcentage des performances exige de préciser le dénominateur : quel score, quelles questions, quelles langues et quelles conditions ? Un rapport obtenu sur un benchmark ne mesure pas une proportion générale d’intelligence. Cet article ne donne aucun pourcentage de conservation, car aucune expérience de distillation n’y a été exécutée.
Un modèle spécialisé demande une maintenance spécialisée
Une fois déployé, l’élève ne suit pas automatiquement l’évolution du professeur. Une mise à jour du service enseignant ne met pas à jour les poids déjà entraînés. De nouveaux exemples, une nouvelle procédure d’apprentissage et une nouvelle évaluation peuvent être nécessaires. Il faut donc conserver les versions comme des objets distincts, avec une date et une description des changements.
La spécialisation peut également devenir une contrainte lorsque le périmètre s’élargit. Un modèle préparé pour une famille de documents n’est pas validé pour toute demande reçue par la même interface. L’application doit reconnaître ses limites d’usage et prévoir une voie alternative : demande de précision, outil spécialisé ou intervention humaine. Cette organisation fait partie de la qualité du système, même si elle ne change pas la taille du modèle.
Ce que cela change pour une entreprise est une possibilité de construire un outil ajusté à une tâche plutôt que de servir partout le système le plus lourd. Mais le bénéfice doit intégrer le travail de création des données, la vérification, les droits et la maintenance. Une petite exécution peut reposer sur une préparation exigeante. Il faut comparer le coût et la qualité du cycle complet.
Ce qui reste à démontrer est finalement très concret : le système obtenu conserve-t-il les capacités nécessaires, sur des demandes nouvelles, dans les conditions prévues ? La distillation donne une méthode pour chercher cette réponse. Les exemples, le protocole et les résultats en fournissent la preuve. Confondre ces deux niveaux transformerait une technique utile en promesse impossible à vérifier.
Pour approfondir cette distinction, consulter le dossier Données synthétiques : utiles pour entraîner, insuffisantes pour prouver ?.
Pour décider si le transfert vaut la peine, on peut préparer une fiche de cas avant de fabriquer les exemples. Chaque cas précise la demande, les informations disponibles et ce qui rendrait la réponse acceptable ou inutilisable. Une explication bien rédigée ne doit pas masquer une catégorie erronée, un calcul faux ou une contrainte oubliée. La fiche permet aussi de repérer les désaccords entre évaluateurs. Dans cette méthode proposée, on conserve ces désaccords plutôt que de les effacer pour obtenir une moyenne plus flatteuse : ils indiquent souvent un critère à clarifier.
Sources
- Geoffrey Hinton, Oriol Vinyals et Jeff Dean, « Distilling the Knowledge in a Neural Network », 2015 ; présentation primaire Google Research consultée le 19 octobre 2026. Aucun résultat chiffré extrapolé.
- Hugging Face, documentation Transformers « Fine-tuning », consultée le 19 octobre 2026 ; utilisée pour le cadre logiciel d’entraînement, pas comme preuve indépendante d’efficacité de la distillation.