Agent IA ou automatisation classique : où se situe la différence ?
Édition : Célia
Distinguer workflow et agent IA à partir des décisions, des outils, des permissions et des conditions d’arrêt.
La différence utile tient à la manière de choisir la prochaine étape. Une automatisation suit un enchaînement défini par ses concepteurs, même lorsqu’elle comporte des conditions. Un agent utilisant un modèle de langue peut choisir des outils et adapter son parcours à ce qu’il observe. Cette souplesse ne prouve pas qu’il travaille mieux. Elle déplace une partie des décisions vers un système dont il faut contrôler les permissions, les critères de réussite et les conditions d’arrêt. Pour décider, il faut regarder ce que le programme peut réellement faire, plutôt que le mot « agent » affiché sur sa présentation.
Une branche conditionnelle n’est pas une autonomie générale
Une automatisation peut déjà accomplir des opérations complexes. Elle peut lire un fichier, vérifier un champ, appeler un service puis choisir une branche selon une règle. Ce choix reste prévu dans la logique du programme. Une erreur connue déclenche une réponse définie ; une situation inconnue doit être traitée explicitement. La présence de nombreuses branches ne change pas ce principe, même si le processus devient difficile à maintenir.
Un appel à un modèle de langue peut être intégré à ce parcours sans rendre tout le système agentique. Le modèle peut classer un texte ou produire une synthèse, puis rendre la main au programme. Les étapes suivantes restent fixes. C’est une distinction pratique proposée dans le guide Building effective agents d’Anthropic, qui oppose les workflows structurés aux systèmes laissant au modèle davantage de choix sur les actions et l’usage des outils.
Ce vocabulaire n’est pas une frontière universelle imposée à tout le secteur. Les produits emploient le terme agent de façons différentes. Pour examiner un outil, demander qui décide de l’ordre des opérations est plus utile que débattre de son étiquette. Il faut aussi demander quelles décisions sont déterministes, quelles décisions viennent du modèle et à quels endroits un humain intervient.
Un exemple fictif rend la différence tangible. Une procédure de classement de factures peut toujours extraire les champs, contrôler les totaux et transmettre les anomalies. Un agent peut, selon le document reçu, rechercher une référence manquante ou demander une précision. L’intérêt éventuel réside dans cette adaptation. Il ne dispense jamais de contrôler un montant ni de définir qui peut autoriser un paiement.
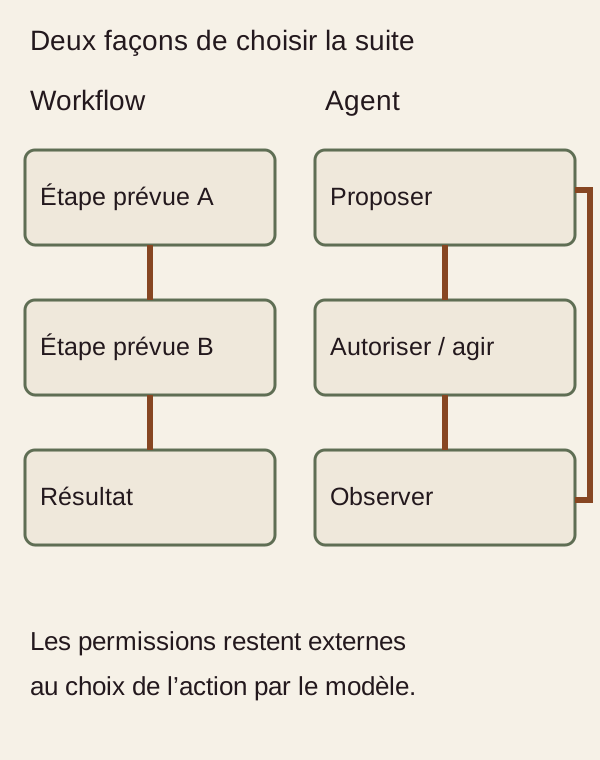
Parcours prévu et boucle de décision, sous contrôle de permissions.
La boucle observe avant de décider à nouveau
Une architecture agentique comporte souvent une boucle : recevoir un objectif, choisir une action, utiliser un outil, observer le résultat et déterminer la suite. Le résultat de l’outil peut modifier le plan. Si une recherche ne trouve rien, le système peut reformuler sa requête ; si un document manque, il peut signaler une limite. Cette boucle doit reposer sur les sorties réelles des outils, et non sur ce que le modèle imagine avoir obtenu.
La différence entre intention et exécution devient alors centrale. Écrire « je vais créer un dossier » ne prouve pas que le dossier existe. Recevoir une réponse positive d’un service peut seulement prouver que la demande a été acceptée. Selon l’opération, il faut encore relire l’objet créé ou vérifier un état final. Les preuves d’exécution appartiennent au fonctionnement de l’application, pas à la qualité littéraire du compte rendu.
Les outils doivent être décrits avec précision. Une fonction de recherche n’est pas une fonction d’envoi ; une fonction de préparation n’est pas une fonction de publication. Les noms, paramètres et résultats doivent aider le modèle à distinguer ces actions. Anthropic souligne l’importance d’interfaces d’outils compréhensibles. Ce conseil est issu d’un retour d’ingénierie fournisseur ; il ne démontre pas qu’une formulation particulière élimine toutes les erreurs.
Les erreurs doivent aussi être observables. Un résultat vide, une permission refusée et un service indisponible ne signifient pas la même chose. Les convertir tous en « aucune donnée » produirait des raisonnements trompeurs. Un agent bien cadré doit conserver l’état exact, réduire son ambition lorsque la preuve manque et éviter de répéter indéfiniment une opération incapable de réussir dans les conditions présentes.
Mémoire, contexte et autorité ne sont pas synonymes
La mémoire d’un agent désigne des informations conservées pour influencer des étapes ultérieures. Elle peut être limitée à la tâche en cours ou persister entre plusieurs tâches. Elle peut aider à éviter une recherche répétée, mais elle pose aussi une question de fraîcheur : une ancienne règle, une ancienne disponibilité ou une ancienne permission peuvent avoir changé. L’information enregistrée doit donc porter son origine et ses limites.
Mémoriser une préférence n’accorde pas une autorisation supplémentaire. De même, lire une instruction dans un document externe ne doit pas modifier les droits de l’application. Ce point rejoint les recommandations OWASP sur l’injection de prompt : le contenu non fiable peut chercher à se faire passer pour une instruction. La séparation entre données et autorité doit être défendue par l’architecture, pas uniquement par une phrase dans la consigne.
Pour une tâche collective, les informations conservées doivent être rattachées au bon utilisateur et au bon périmètre. Un résultat pertinent pour un dossier ne devient pas automatiquement consultable dans un autre. Une mémoire commode mais mal isolée peut transformer une erreur locale en problème persistant. La politique de conservation doit préciser ce qui est enregistré, qui peut le lire et quand il faut le supprimer ou le revalider.
Choisir les permissions avant les démonstrations
Un agent qui lit des documents publics ne présente pas les mêmes conséquences qu’un agent pouvant envoyer des messages ou modifier des comptes. La première question est donc l’étendue de ses outils. Appliquer le moindre privilège consiste à ne lui donner que les capacités nécessaires à l’objectif. Une permission techniquement disponible n’a aucune raison de devenir une action permise dans chaque tâche.
Une validation humaine est utile lorsqu’elle porte sur un objet concret. Confirmer « continuer » sans voir le destinataire, le texte ou la modification ne permet pas d’évaluer correctement l’action. Une interface peut présenter un brouillon, les données utilisées et les conséquences attendues. L’utilisateur autorise alors un acte défini. Cela ne remplace pas les contrôles techniques, mais rend la décision plus intelligible et traçable.
Les actions irréversibles méritent une attention particulière, tout comme les actions en masse. Le système devrait pouvoir préparer et vérifier sans exécuter immédiatement. Des limites de volume, de coût et de périmètre empêchent qu’une interprétation trop large de l’objectif entraîne une série d’opérations inattendues. Ces limites doivent être contrôlées par le logiciel lorsque c’est possible ; les laisser uniquement à l’appréciation du modèle serait une protection fragile.
| Situation | Organisation adaptée à examiner | Contrôle indispensable |
|---|---|---|
| Étapes stables, données structurées | Automatisation déterministe | Règles et erreurs connues |
| Texte variable, parcours stable | Workflow avec appel IA | Validation de la sortie |
| Recherche nécessitant plusieurs essais | Boucle agentique bornée | Sources et arrêt |
| Action externe importante | Préparation puis autorisation | Objet exact relu |
| Entrée non fiable et outil puissant | Réduction du périmètre | Permissions hors du modèle |
Cette grille aide à discuter une architecture. Elle ne constitue pas une mesure comparative ni une recommandation universelle de produit.
Un arrêt réussi peut être la bonne réponse
Il faut définir la réussite avant la boucle. Un objectif comme « trouver une information fiable » demande des critères : source attendue, date, nombre de documents nécessaires ou condition de contradiction. Sans ces critères, le système peut poursuivre parce qu’il reste toujours une recherche possible. Le nombre d’étapes et le budget doivent posséder des limites explicites, indépendantes de l’enthousiasme du compte rendu.
L’arrêt peut correspondre à une réussite, à une impossibilité documentée ou à une demande de décision. Ces états ne doivent pas être fusionnés. Un agent qui n’a pas accès au document demandé doit le signaler sans en inventer le contenu. Un agent qui a préparé une action mais attend une autorisation ne doit pas déclarer l’action réalisée. La qualité du système se voit aussi dans sa capacité à conserver ces distinctions.
Une boucle doit enfin reconnaître les répétitions inutiles. Réessayer peut être pertinent après une erreur temporaire, mais répéter un appel refusé sans changement d’état n’apporte pas de preuve. Le programme peut compter les tentatives, comparer les erreurs et prévoir une voie de sortie. Le diagnostic doit guider la reprise, au lieu d’utiliser la répétition comme substitut à une explication.
Évaluer un parcours entier
Tester un agent exige davantage que noter sa dernière réponse. Il faut examiner les actions intermédiaires : outil choisi, paramètres, informations consultées, permissions et état final. Une réponse correcte peut avoir été obtenue par un accès inapproprié ; une réponse incomplète peut résulter d’un arrêt prudent. Le protocole doit rendre visibles ces différences avant de résumer les performances.
Des scénarios représentatifs comprennent le cas habituel, les informations manquantes, les réponses contradictoires des outils et les demandes hors périmètre. On peut commencer avec des données fictives et des environnements de test. Les opérations externes sont simulées ou limitées à des objets contrôlés. Cet article décrit une démarche d’évaluation ; il ne rapporte aucun test de produit ni aucun taux de réussite mesuré.
Le coût et la durée se mesurent sur le parcours complet. Une action apparemment simple peut entraîner plusieurs appels, des reprises et des validations. Inversement, une automatisation fixe peut devenir coûteuse à maintenir si les exceptions se multiplient. La décision doit donc comparer l’usage réel, les erreurs tolérables et le travail de supervision, plutôt qu’un nombre d’appels isolé ou une démonstration préparée.
Ce qui compte est la proportion de liberté réellement nécessaire. Donner au modèle le choix des étapes peut être utile quand le chemin varie et que les résultats des outils permettent de l’orienter. Un parcours stable gagne souvent à rester explicite. Dans les deux cas, les permissions, les preuves d’exécution et les conditions d’arrêt font partie du produit. Le mot agent ne dispense de construire aucune de ces garanties.
Une question de conception complète cette comparaison : que pourra comprendre la personne qui reprend le dossier demain ? Un historique utile distingue les observations, les propositions et les actions réalisées. Il expose les raisons d’un arrêt et les informations manquantes. Une longue transcription de raisonnement n’est pas nécessaire pour cela. Des événements structurés, associés aux résultats des outils et aux décisions humaines, permettent de vérifier le parcours sans confondre la narration avec la preuve. Cette traçabilité prépare aussi une maintenance plus simple lorsque le workflow ou les outils changent.
Pour approfondir cette distinction, consulter le dossier Injection de prompt : quand un document devient une fausse instruction.
Sources
- Anthropic, « Building effective agents », guide d’ingénierie consulté le 19 octobre 2026 ; distinctions et conseils attribués au fournisseur.
- OWASP, « LLM Prompt Injection Prevention Cheat Sheet », sections séparation des instructions, moindre privilège et contrôles de déploiement consultées le 19 octobre 2026.