Essais cliniques et données de vie réelle : quelles preuves se complètent ?
Édition : Pierre
Comparer essais cliniques et données de vie réelle : comprendre leurs apports, les biais possibles et les limites d’une conclusion causale.
Les essais cliniques et les données de vie réelle éclairent des questions parfois différentes. Un essai peut organiser une comparaison pour étudier l’effet d’une intervention. Des données recueillies dans les soins courants peuvent décrire des usages, des populations et des événements sur une autre échelle. Leur intérêt dépend de la question, de la qualité des informations et de la méthode d’analyse. Une base volumineuse ne transforme pas automatiquement une association en causalité. Pour comprendre ce que ces approches apportent ensemble, il faut distinguer l’origine des données du plan d’étude qui les utilise.
La vie réelle décrit d’abord une origine de données
Les dossiers de santé, les registres et les informations liées aux soins peuvent contenir des observations sur les caractéristiques des patients, les traitements et les résultats. L’Agence européenne des médicaments, ou EMA, définit les données de vie réelle par leur lien avec la pratique clinique courante. Les preuves de vie réelle résultent de leur analyse. Les données et les conclusions ne sont donc pas synonymes.
Cette distinction paraît simple, mais elle évite un raccourci fréquent. Un entrepôt de données n’est pas encore une étude. Pour produire une réponse, il faut définir la population, la période, les traitements, les résultats et la comparaison. La même source peut être utile pour une question et insuffisante pour une autre. La quantité de dossiers n’efface pas ce problème d’adéquation.
Les données collectées pour les soins répondent d’abord aux besoins du soin et de son organisation. Elles ne contiennent pas nécessairement tous les détails qu’une question de recherche demanderait. Un code administratif, une prescription et une mesure clinique ne racontent pas exactement la même chose. Leur signification doit être examinée avant de les utiliser comme variables dans une analyse.
La première lecture d’une étude consiste donc à demander d’où vient chaque information et comment elle a été définie. Une mention de « données hospitalières » reste trop large. Il faut comprendre les établissements concernés, les périodes couvertes et les règles de sélection, sans supposer que toute la trajectoire d’une personne est visible dans une seule base.
Essai et données courantes ne s’opposent pas toujours
La FDA explique dans ses recommandations de 2023 que les données de vie réelle peuvent également être utilisées dans des recherches interventionnelles. Elles peuvent aider à identifier des participants, renseigner des résultats ou fournir certaines informations de comparaison. Il serait donc faux de classer toutes les données courantes d’un côté et tous les essais de l’autre.
Le plan d’étude est une dimension distincte. Dans un essai randomisé, l’attribution de l’intervention suit une procédure aléatoire prévue par le protocole. Dans une étude non interventionnelle, le traitement peut être choisi dans la pratique médicale selon la situation du patient et le jugement du professionnel. Cette différence influence la manière dont les résultats peuvent être interprétés.
Un essai n’est pas automatiquement parfait parce qu’il est randomisé. Son comparateur, ses participants, sa durée et ses données manquantes doivent aussi être examinés. À l’inverse, une étude observationnelle peut fournir des informations très utiles si sa question et ses limites sont bien définies. L’évaluation ne se réduit pas à coller une étiquette générale sur une méthode.
On peut ainsi poser deux questions séparées : comment les données ont-elles été produites, et comment la comparaison a-t-elle été organisée ? Cette séparation aide à comprendre les études hybrides et évite de donner au mot « réel » une valeur de supériorité automatique. Les résultats d’un essai se produisent eux aussi chez de vraies personnes, dans des conditions définies.
Pourquoi les groupes peuvent différer avant le traitement
Dans les soins courants, deux personnes ne reçoivent pas nécessairement le même traitement parce qu’elles ont des profils différents. La gravité, les autres maladies ou les traitements antérieurs peuvent influencer la décision. Ces caractéristiques peuvent également influencer le résultat étudié. Une comparaison brute risque alors de mélanger l’effet du produit avec celui de la sélection des personnes qui le reçoivent.
Ce problème correspond à la confusion. Pour le comprendre, imaginons un exemple purement illustratif : une option est réservée aux situations les plus difficiles, et son groupe présente ensuite davantage de complications. Cela ne démontre pas à lui seul que l’option cause ces complications. La situation initiale peut contribuer à la différence. L’exemple n’attribue aucun effet à un traitement réel.
Les méthodes d’analyse cherchent à tenir compte des différences pertinentes. Leur capacité dépend des informations disponibles, de leur qualité et des hypothèses retenues. Un facteur non mesuré ne devient pas observé parce que l’algorithme est complexe. La correction statistique doit donc être présentée avec sa portée, sans promettre de supprimer tous les biais.
La documentation EMA sur les études non interventionnelles constitue une référence pour examiner ces questions méthodologiques. Pour toute conclusion causale, la lecture détaillée du protocole et des analyses reste nécessaire. Le présent dossier explique le mécanisme du problème, sans certifier une étude particulière.
Les absences dans les données ont une histoire
Une mesure peut manquer parce qu’elle n’était pas nécessaire dans le parcours habituel, parce qu’elle a été réalisée ailleurs ou parce qu’elle n’a pas été enregistrée dans le format utilisé. Ces situations ne sont pas équivalentes. L’absence d’un code ne signifie pas automatiquement l’absence d’une maladie, d’un examen ou d’un événement.
La durée visible du suivi est également importante. Une personne peut changer d’établissement ou de système de couverture. Si la base cesse alors de recueillir certaines informations, les chercheurs doivent examiner ce que cette interruption signifie pour leur analyse. Un suivi annoncé sur une longue période ne suffit pas à prouver que toutes les trajectoires sont documentées de façon comparable.
Les définitions des variables doivent être suffisamment explicites pour être discutées. Par exemple, une prescription renseigne sur un acte de prescription ; elle n’établit pas à elle seule la prise effective du médicament selon le schéma prévu. Le choix d’une variable de substitution peut être raisonnable, mais sa limite doit accompagner l’interprétation.
Ce qui compte : les informations manquantes ne sont pas seulement un défaut à nettoyer. Elles peuvent refléter le fonctionnement des soins et la sélection des personnes observées. Les comprendre aide à déterminer si la source répond à la question, ou si une autre collecte est nécessaire.
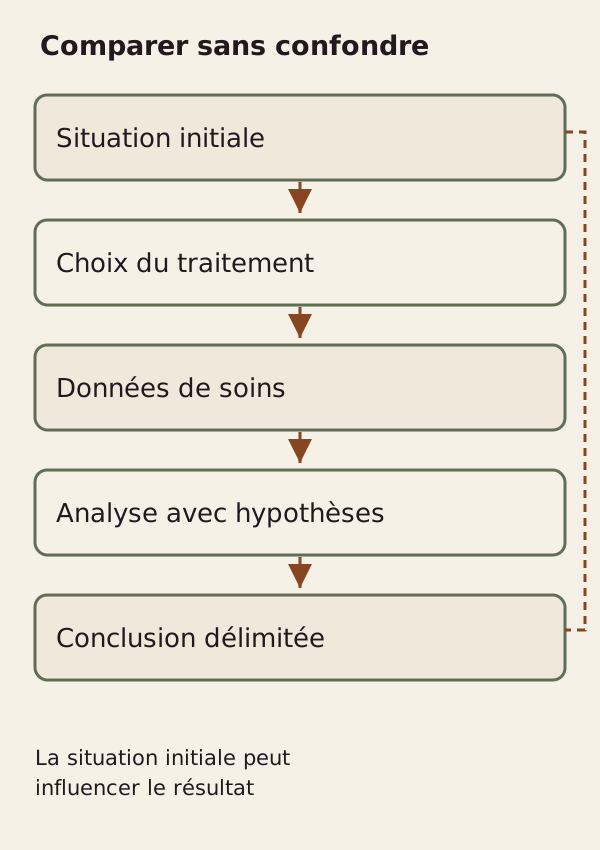
Le dessin illustre un facteur de confusion. Il ne représente ni une analyse statistique exécutée ni les résultats d’un groupe de patients.
Ce que les données courantes peuvent apporter
L’EMA présente plusieurs usages des études de vie réelle : décrire l’utilisation des médicaments, l’épidémiologie des maladies, la sécurité et l’efficacité, ainsi que préparer des études. Le réseau DARWIN EU est présenté comme une capacité destinée à produire des analyses à partir de bases de soins. Son existence ne signifie pas que chaque base ou chaque question donnera une réponse fiable.
Ces données peuvent aider à observer des pratiques qui ne sont pas l’objet principal d’un essai. Elles peuvent aussi documenter des populations ou des durées différentes de celles étudiées initialement. Il faut toutefois vérifier la présence réelle de ces populations et la qualité de leur suivi. L’expression « plus représentatif » demande une comparaison, pas une intuition.
Elles peuvent enfin faire apparaître des signaux qui méritent d’être examinés avec d’autres méthodes. Un signal est utile même lorsqu’il ne démontre pas encore une causalité. L’erreur serait de le présenter immédiatement comme une conclusion définitive, ou de l’ignorer au seul motif qu’il provient d’observations non randomisées.
La complémentarité se construit donc question par question. Une étude peut expliquer comment un produit est utilisé ; une autre peut mieux isoler son effet ; une troisième peut examiner une population particulière. Les résultats ne deviennent pas interchangeables pour autant. Leur rapprochement demande de comparer les définitions et les contextes.
Lire les divergences plutôt que les masquer
Lorsque deux études ne trouvent pas la même chose, il faut d’abord vérifier qu’elles posent la même question. Le traitement, le comparateur, la population, le résultat et la durée peuvent différer. Deux conclusions apparemment opposées peuvent concerner des situations distinctes. À l’inverse, un accord apparent peut masquer des méthodes partageant les mêmes limites.
On peut construire une fiche de correspondance avant de chercher une explication. Elle indique précisément les éléments communs et les différences. Ce travail évite de choisir l’étude qui confirme une préférence préalable. Il permet aussi de repérer une question qui n’a été traitée directement par aucune des deux recherches.
| Dimension | Essai organisé | Données de soins analysées | À comparer |
|---|---|---|---|
| Attribution | Définie par le protocole | Souvent issue de la pratique | Facteurs de sélection |
| Population | Critères d’inclusion précis | Population visible dans la source | Exclusions et couverture |
| Mesure | Collecte prévue pour l’étude | Données initialement recueillies pour les soins | Définition et qualité |
| Suivi | Échéances prévues | Trajectoires observables | Pertes d’information |
| Conclusion | Dépend du plan et de l’exécution | Dépend des données et des hypothèses | Portée exacte de l’inférence |
Ce tableau est une grille pédagogique, pas une hiérarchie universelle. Certains essais utilisent des données courantes et certaines études observationnelles organisent une collecte spécifique. Il faut toujours revenir au protocole réel plutôt que forcer une étude dans une catégorie simplifiée.
Ce qui reste à démontrer
Une analyse de données de vie réelle gagne en crédibilité lorsqu’elle précise sa question à l’avance, décrit ses sources et examine les limites de ses choix. La reproductibilité exige de conserver les définitions et les étapes d’analyse, dans le respect de la confidentialité. Elle ne suppose pas de rendre publics des dossiers individuels de santé.
Pour le lecteur, l’enjeu est de reconnaître la conclusion réellement soutenue. Décrire une fréquence d’usage, repérer une association et estimer un effet causal sont trois ambitions différentes. Une base peut répondre solidement à la première tout en restant insuffisante pour la troisième. La qualité du travail se juge aussi à sa capacité à maintenir cette limite.
Les essais et les données de vie réelle se complètent lorsqu’ils réduisent des incertitudes différentes. Leur combinaison ne consiste pas à additionner des chiffres hétérogènes, mais à relier des preuves dont la population, la méthode et la portée sont explicites. C’est cette précision qui transforme des observations abondantes en connaissance utile.
Le point de départ du suivi peut changer l’interprétation
Le document méthodologique de l’EMA souligne les biais liés au temps. Pour comparer des groupes, il faut définir de manière cohérente le moment où une personne devient éligible, celui où le traitement commence et celui où le suivi démarre. Une mauvaise attribution des périodes observées peut modifier l’association calculée.
Cette question rappelle que les dates ne sont pas de simples colonnes administratives. Elles définissent l’exposition et les occasions d’observer un événement. Le protocole doit expliciter les choix et examiner leur influence. Une analyse de sensibilité peut aider à comprendre ce qui change lorsque certaines hypothèses sont modifiées, sans garantir que toutes les incertitudes disparaissent.
Sources et périmètre
Sources lues le 19 octobre 2026 : FDA, recommandations sur les données et preuves de vie réelle, 2023 ; EMA, page institutionnelle et définitions disponibles. Le document méthodologique EMA/99865/2025 a été lu pour ses sections sur les biais, la confusion et la qualité des données ; aucune étude clinique individuelle n’est évaluée ici.